Die besten Mini-PCs für lokale KI 2026
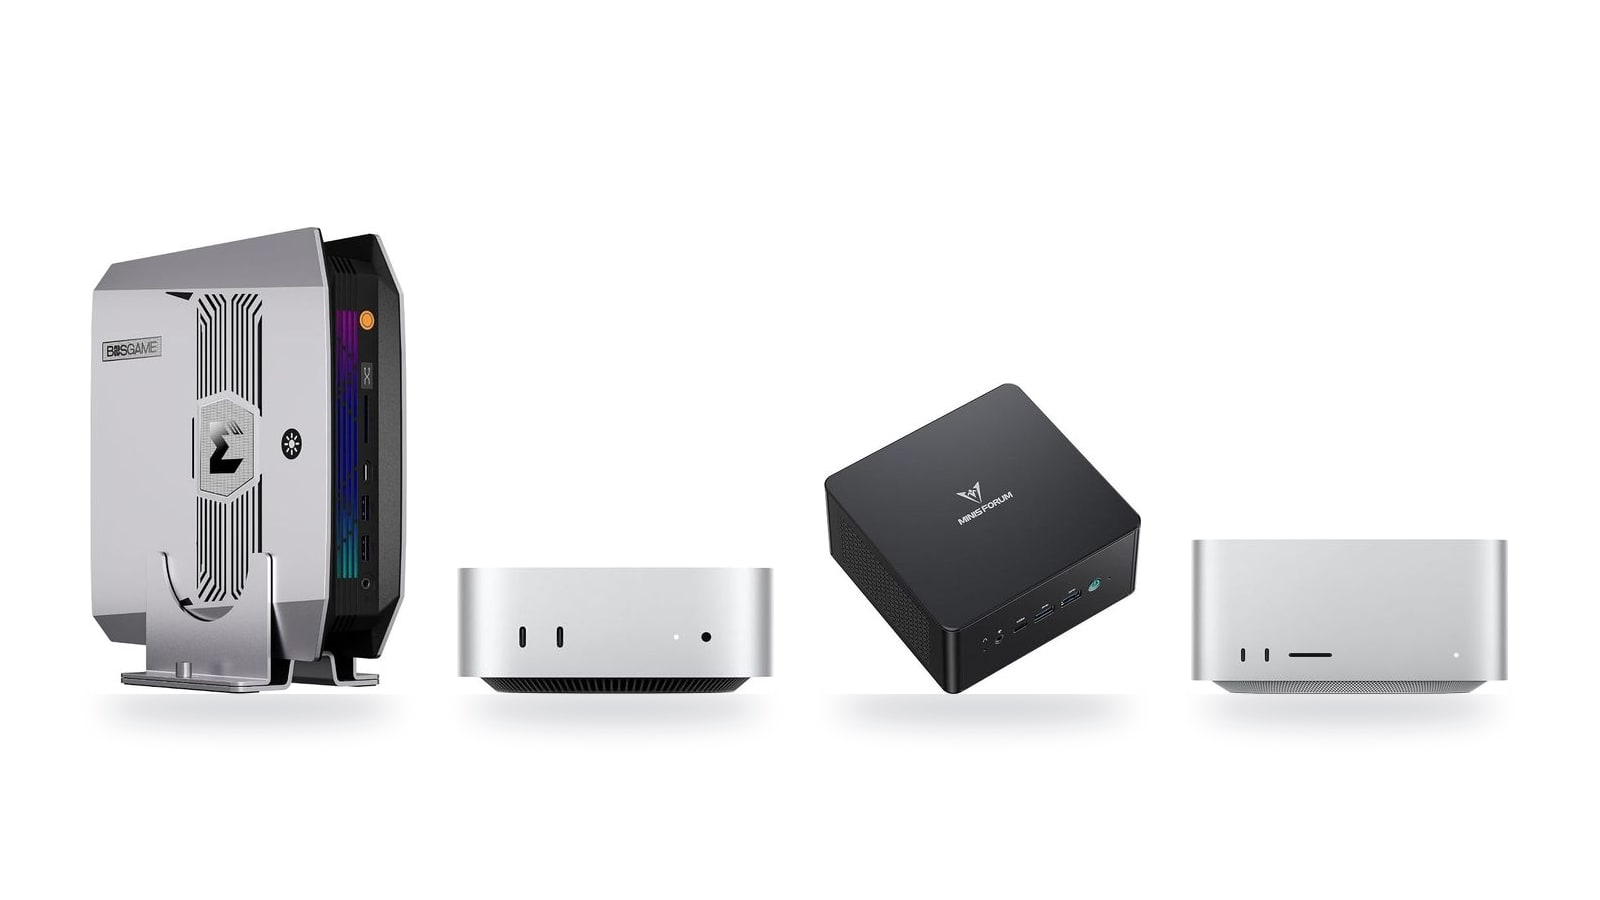
Qwen 3.8-27B schlägt Claude Opus 4.6 in mehreren Benchmarks und braucht als Q4-Quant nur rund 16 GB. Ob ein Mini-PC das stemmt, hängt also fast nur am Arbeitsspeicher. Hier findest du, welches Gerät für welche Modellgröße und welches Budget passt.
Unsere Empfehlungen je Einsatzzweck
Du willst nicht sieben Datenblätter vergleichen? Dann reichen diese vier Empfehlungen. Entscheidend ist bei allen der gemeinsame Speicher, denn er legt fest, welches Sprachmodell (LLM) überhaupt hineinpasst. Was nach den Modellgewichten übrig bleibt, muss für Kontext und Betriebssystem reichen.
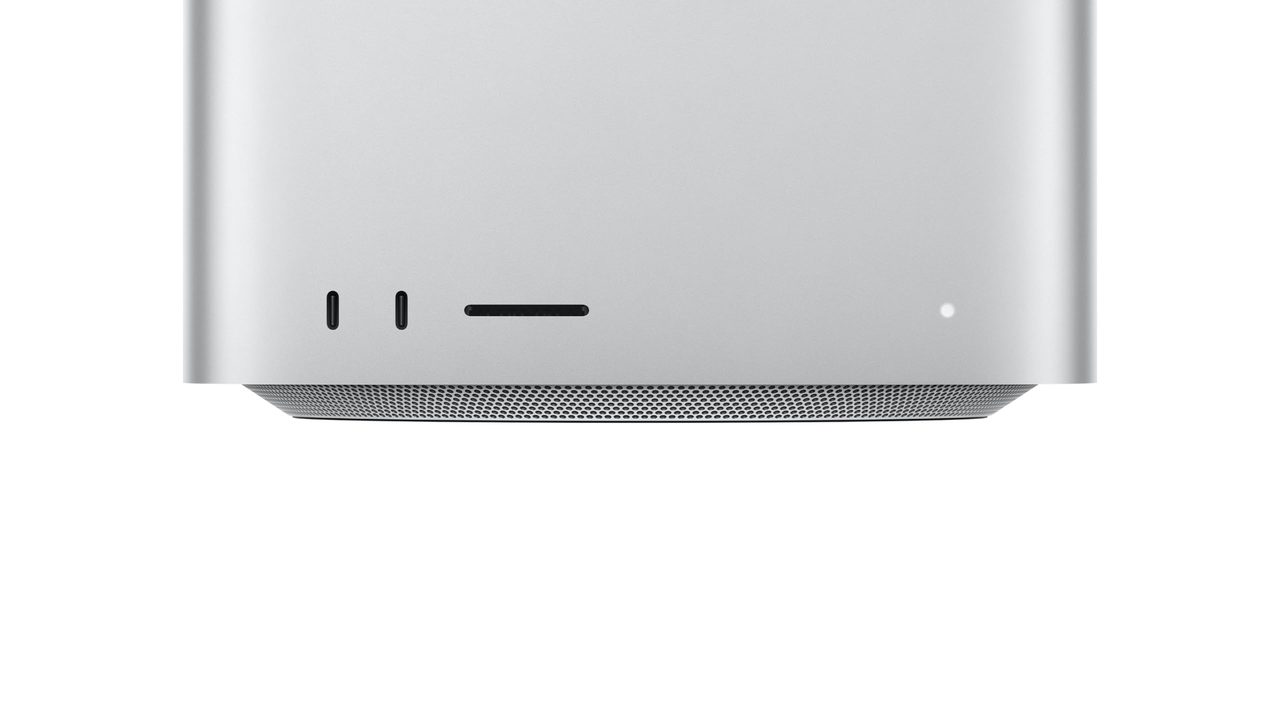
Für alle, die Qwen 3.8-27B täglich und mit langen Dokumenten oder großen Codebasen nutzen wollen. Nach den rund 16 GB für die Modellgewichte bleiben von den 36 GB Unified Memory etwa 20 GB für langen Kontext und macOS. Dazu kommt MLX als schnelle Apple-eigene Laufzeitumgebung.
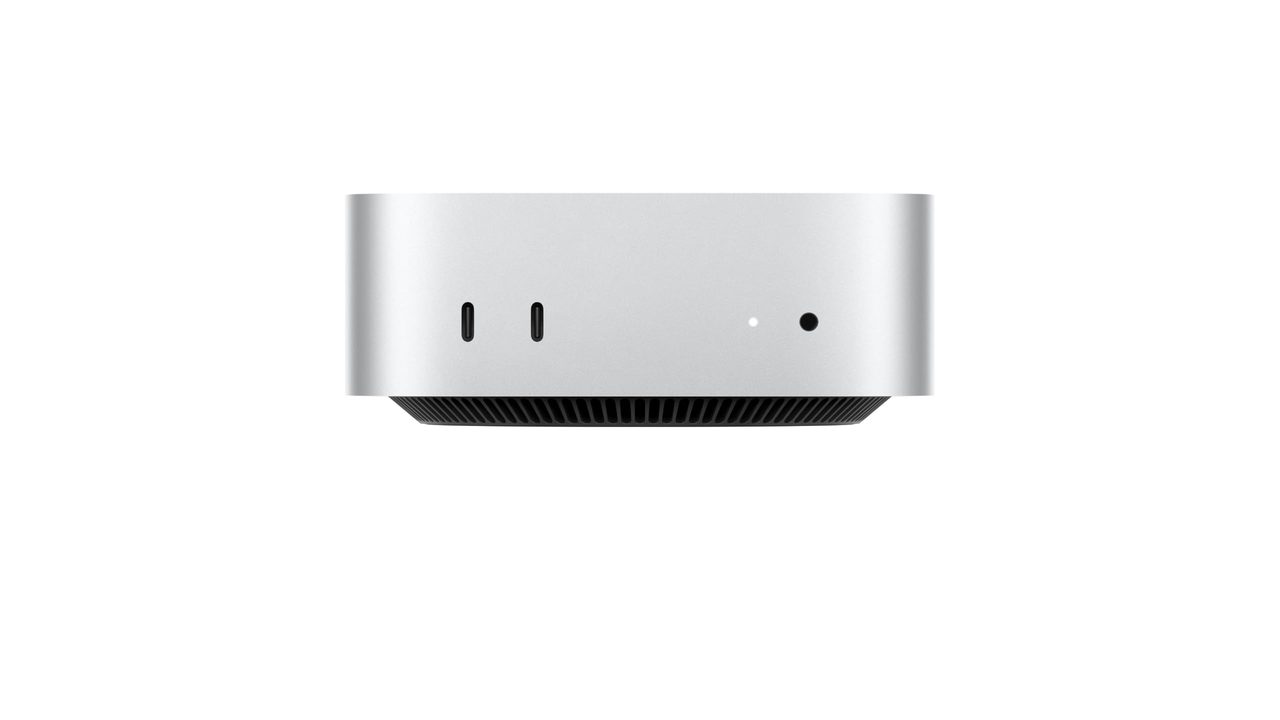
Für 1.299 € ist das der günstigste Weg zu einem aktuellen Apple-Chip mit KI-tauglichem Speicher. Ein 27B-Modell als Q4-Quant passt hinein. Nach Gewichten und macOS bleiben aber nur wenige Gigabyte übrig, beim Kontext wird es knapp. Tom's Guide nennt ihn aktuell den besten Mini-PC.
Mit 1.159 € ist er der günstigste Weg zu 32 GB RAM in dieser Auswahl. Er kostet 140 € weniger als der Mac mini M6 und hat 8 GB mehr Speicher. Sprachmodelle laufen mit llama.cpp über Vulkan. Das ist nicht so komfortabel wie MLX auf dem Mac, reicht für 27B-Modelle aber gut aus.
Er hat 128 GB gemeinsamen Speicher und ist damit das einzige Gerät hier, das Modelle weit über 27B ausführt. Das gilt etwa für 70B-Klassen als Q4-Quant oder für 27B mit sehr großem Kontextfenster. Der Preis von 3.699 € lohnt sich aber nur, wenn du diese Größen wirklich brauchst.
Faustregel: Bleibst du bei 27B-Modellen, reichen dir der Mac Studio oder der UM890 Pro, mit Abstrichen beim Kontext auch der Mac mini M6. Den Bosgame M5 solltest du nur kaufen, wenn du gezielt größere Modelle ausführen willst. Mehr CPU-Kerne bringen dir ohne mehr Arbeitsspeicher kein größeres Modell.
Diese Seite enthält Affiliate-Links. Kaufst du über einen dieser Links, erhalten wir eventuell eine Provision. Für dich ändert sich der Preis dadurch nicht. Unsere Empfehlungen beruhen auf Recherche und dem Vergleich öffentlich zugänglicher Quellen, nicht auf eigenen Labormessungen.
Alle sechs Mini-PCs im Vergleich
| Produkt | Bewertung | Preis | Kaufen |
|---|---|---|---|
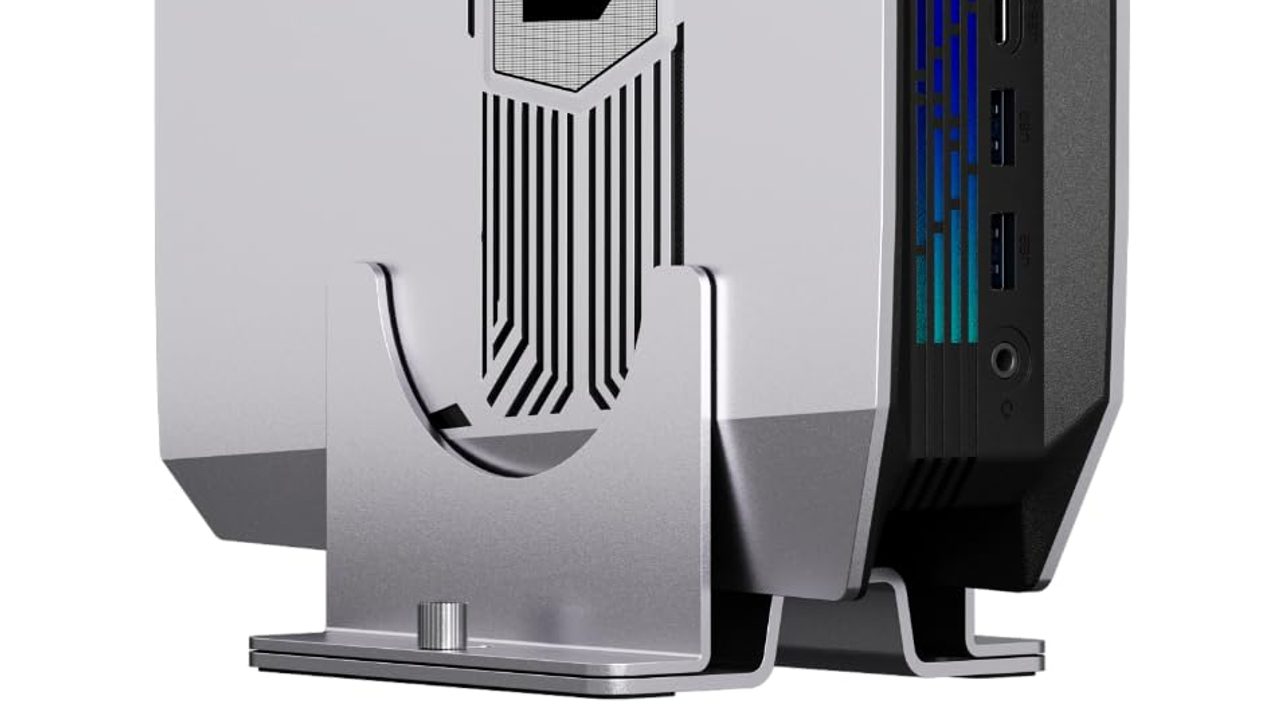
 Bosgame M5 (Ryzen AI Max+ 395, 128 GB, 2 TB) 128 GB Unified Memory im Mini-PC: Platz für große lokale LLMs +128 GB Unified Memory für große LLMs+Radeon 8060S: Bildgenerierung ohne Grafikkarte -RAM verlötet, später nicht aufrüstbar | 3.699,00 € | Kaufen → | |
 Apple Mac mini (M5 Pro, 24 GB, 512 GB) Top-Empfehlung 24 GB Unified Memory und 307 GB/s: lokale 27B-Modelle in einem 12,7-cm-Würfel +24 GB: 27B-Modelle als 4-Bit-Quant+307 GB/s: zügigere Token-Ausgabe -24 GB: wenig Puffer für Langkontext | 1.699,00 € | Kaufen → | |
| Apple Mac mini (M6, 24 GB, 512 GB) 24 GB Unified Memory: Qwen 3.8-27B im 4-Bit-Quant auf dem Schreibtisch +24 GB: 27B-Modelle als 4-Bit-Quant+Neural Accelerator pro GPU-Kern beschleunigt KI -24 GB: wenig Reserve für langen Kontext | 1.299,00 € | Kaufen → | |
 Minisforum UM890 Pro (32 GB, 1 TB) 32 GB RAM, auf 96 GB aufrüstbar, und Oculink für eine externe Grafikkarte: ein günstiger Einstieg i… +Oculink: externe Grafikkarte für schnellere KI+32 GB fassen 4-Bit-Modelle bis 27B -Radeon 780M: LLMs antworten spürbar langsam | 1.159,00 € | Kaufen → | |
 Apple Mac Studio (M5 Max, 36 GB) 36 GB Unified Memory für 27B-Modelle wie Qwen 3.8 – leise auf dem Schreibtisch +36 GB: Qwen 3.8-27B passt komplett+Neural Accelerator je GPU-Kern -36 GB verlötet, später nicht aufrüstbar | 2.599,00 € | Kaufen → | |
 GEEKOM IT15 (Core Ultra 9 285H, 32 GB, 1 TB) Core Ultra 9 285H und 32 GB DDR5: kompakter Einstieg für kleine lokale KI-Modelle +Zwei SODIMM-Slots: RAM später aufrüstbar+Zweiter M.2-Slot für Modellbibliothek -Keine eigene GPU: größere LLMs laufen zäh | 1.399,00 € | Kaufen → |
Preise vom 16. Nov. 2026, sie können sich inzwischen geändert haben.
Die Geräte kurz eingeordnet

128 GB Unified Memory im Mini-PC: Platz für große lokale LLMs
- 128 GB Unified Memory für große LLMs
- Radeon 8060S: Bildgenerierung ohne Grafikkarte
- 2 TB SSD plus freier M.2-Slot
- RAM verlötet, später nicht aufrüstbar
- Unter KI-Dauerlast hörbar laut

24 GB Unified Memory und 307 GB/s: lokale 27B-Modelle in einem 12,7-cm-Würfel
- 24 GB: 27B-Modelle als 4-Bit-Quant
- 307 GB/s: zügigere Token-Ausgabe
- KI-Beschleuniger je GPU-Kern: schnellere Prompts
- 24 GB: wenig Puffer für Langkontext
- RAM nicht nachrüstbar, Kauf ist endgültig
24 GB Unified Memory: Qwen 3.8-27B im 4-Bit-Quant auf dem Schreibtisch
- 24 GB: 27B-Modelle als 4-Bit-Quant
- Neural Accelerator pro GPU-Kern beschleunigt KI
- Kompaktes Gehäuse passt unter jeden Monitor
- 24 GB: wenig Reserve für langen Kontext
- Maximal 32 GB, kein Upgrade nachträglich

32 GB RAM, auf 96 GB aufrüstbar, und Oculink für eine externe Grafikkarte: ein günstiger Einstieg i…
- Oculink: externe Grafikkarte für schnellere KI
- 32 GB fassen 4-Bit-Modelle bis 27B
- RAM auf 96 GB aufrüstbar
- Radeon 780M: LLMs antworten spürbar langsam
- DDR5-RAM bremst größere Modelle aus

36 GB Unified Memory für 27B-Modelle wie Qwen 3.8 – leise auf dem Schreibtisch
- 36 GB: Qwen 3.8-27B passt komplett
- Neural Accelerator je GPU-Kern
- 4× Thunderbolt 5 für KI-Cluster
- 36 GB verlötet, später nicht aufrüstbar
- 512 GB SSD füllt sich mit Modellen

Core Ultra 9 285H und 32 GB DDR5: kompakter Einstieg für kleine lokale KI-Modelle
- Zwei SODIMM-Slots: RAM später aufrüstbar
- Zweiter M.2-Slot für Modellbibliothek
- 2,5 GbE: große Modelle schneller laden
- Keine eigene GPU: größere LLMs laufen zäh
- 32 GB teilen sich CPU und Grafik

15 W TDP und 2,5G LAN: sparsamer Dauerläufer für kleine KI-Agenten
- 15 W TDP: sparsam im 24/7-Betrieb
- 2,5G LAN: schneller Zugriff im Heimnetz
- RAM auf bis 64 GB nachrüstbar
- 16 GB: Qwen 3.8-27B passt nicht
- Keine dedizierte GPU für Bildgenerierung
Preise vom 16. Nov. 2026, sie können sich inzwischen geändert haben.
Was lokale KI leistet und worauf es beim Kauf ankommt
Lokale Sprachmodelle liegen im November 2026 etwa ein halbes Jahr hinter der Cloud-Spitze von Anthropic, OpenAI und Google, also hinter Modellen wie Claude Opus 5.5. Das ist weniger, als es klingt: Claude Opus 4.6, das Qwen 3.8-27B in mehreren Benchmarks schlägt, war im Februar 2026 noch das führende Cloud-Modell. Für Programmieren, Zusammenfassen und Textarbeit reicht das heute schon. Mit Qwen 4 steht außerdem der nächste Sprung kurz bevor. Der Abstand zur Cloud schrumpft also weiter, und dein Gerät wird mit jedem neuen Modell nützlicher.
Welches Modell du ausführen kannst, hängt fast nie von der CPU ab. Die Kriterien unten sind nach Wichtigkeit sortiert.
- 1. Arbeitsspeicher (RAM) — Unified Memory oder VRAM legt fest, wie groß dein Modell sein darf. 24 GB im Apple Mac mini (M6) reichen knapp für 27B als Q4. Mit 32 GB im Minisforum UM890 Pro oder 36 GB im Apple Mac Studio (M5 Max) bleibt Luft für längeren Kontext. Die 16 GB im Geekom A5 Pro reichen nur für kleine Modelle.
- 2. Speicherbandbreite — Sie bestimmt die Token pro Sekunde, weil für jedes erzeugte Token die kompletten Gewichte aus dem Arbeitsspeicher gelesen werden. Doppelte Bandbreite bedeutet grob doppeltes Tempo. Hier liegt der eigentliche Vorsprung des M5 Max gegenüber dem M6.
- 3. Software-Unterstützung — MLX gibt es nur auf dem Mac. Bei AMD-Geräten wie dem Bosgame M5 oder dem UM890 Pro nutzt du ROCm oder Vulkan. llama.cpp läuft überall, auch auf dem GEEKOM IT15.
- 4. Lautstärke und Leistungsaufnahme — Läuft das Gerät als KI-Server rund um die Uhr, sollte der Lüfter leise bleiben und der Verbrauch im Leerlauf niedrig sein. Was das in Euro bedeutet, rechnet der Kasten weiter unten vor.
- 5. CPU und NPU — Beide spielen für Sprachmodelle kaum eine Rolle. Ein Core Ultra 9 oder viele CPU-Kerne bringen bei der Textgenerierung praktisch nichts, solange der Speicher bremst.
Speicher vor Rechenleistung
Die wichtigste Regel: Passt das Modell nicht komplett in den schnellen Speicher, wird es unbrauchbar langsam. Deshalb ist ein Mac mini M5 Pro mit 24 GB für große Modelle nicht besser als der günstigere M6 mit ebenfalls 24 GB. Er rechnet zwar schneller, darf aber kein größeres Modell laden. Mehr als 36 GB, etwa die 128 GB im Bosgame M5, lohnen sich erst, wenn du gezielt Modelle jenseits von 30B, etwa aus der 70B-Klasse, oder sehr lange Kontexte nutzen willst.
Software: so schnell läuft das erste Modell
Am einfachsten startest du mit llama.cpp oder dem Docker Model Runner. Googles Gemma 4 holst du dir mit einer Zeile auf die Platte:
docker model pull gemma4
Auf dem Mac liefert MLX meist etwas mehr Tempo, weil es speziell für Apple Silicon optimiert ist. Bei AMD solltest du vor dem Kauf prüfen, ob ROCm deine Grafikeinheit offiziell unterstützt. Vulkan ist die robustere Notlösung.
Jedes Watt, das ein Gerät dauerhaft verbraucht, summiert sich auf 8,76 kWh pro Jahr. Bei angenommenen 35 Cent pro kWh kostet dich das rund 3 € pro Watt und Jahr. Ein Server mit 10 W im Leerlauf kostet also etwa 30 € im Jahr, einer mit 30 W rund 90 €. Wer seinen Rechner rund um die Uhr laufen lässt, sollte deshalb vor allem auf den Verbrauch im Leerlauf achten. Die Leistungsaufnahme unter Last ist zweitrangig.
Marktlage und Alternativen zum Mini-PC
Wer 2026 Hardware für lokale KI kauft, zahlt deutlich mehr als noch vor einem Jahr. Der Grund ist die Knappheit bei Speicherchips. Gleichzeitig wollen viel mehr Leute große Sprachmodelle zu Hause ausführen. Genau die Bauteile, die über die Modellgröße entscheiden, sind also knapp und gefragt.
Warum die Preise gestiegen sind
Am deutlichsten sieht man das bei Apple. Der Mac mini startet jetzt bei 1.049 €, früher waren es 699 €. Viele Konfigurationen waren nach der Vorstellung Ende August monatelang kaum lieferbar. Bei Grafikkarten ist es noch extremer. Eine vier Jahre alte RTX 4090 kostet gebraucht rund 4.000 €, also mehr als doppelt so viel wie ihr damaliger Neupreis. Gemessen daran wirken die 1.299 € für den Apple Mac mini (M6, 24 GB, 512 GB) oder die 1.159 € für den Minisforum UM890 Pro (32 GB, 1 TB) beinahe vernünftig.
Die Alternativen im Überblick
| Weg | Was du bekommst | Sinnvoll, wenn … |
|---|---|---|
| Gaming-PC mit Radeon RX 9070 XT | 16 GB Grafikspeicher (VRAM), hohe Tok/s, laut heise brauchbar fürs Programmieren | du ohnehin spielst |
| Notebook mit Nvidia RTX Spark | Arm-Blackwell-Chip mit Unified Memory, Windows ohne AMD oder Intel | du mobil arbeiten willst |
| Mini-PC mit Gorgon Halo und 192 GB | Platz für sehr große Modelle und lange Kontexte | du gezielt Modelle weit jenseits von 27B ausführen willst |
Ein normaler Gaming-PC mit einer Radeon RX 9070 XT (die Karte allein kostet rund 920 €) ist für viele die ehrlichere Wahl. heise bescheinigt ihm brauchbare KI-Arbeit inklusive Programmieren. Die 16 GB Grafikspeicher reichen für ein 27B-Modell als Q4 aber nur knapp, bei langem Kontext wird es eng. Wenn du ohnehin spielst, bezahlst du die Hardware nur einmal und bekommst zwei Einsatzzwecke.
Nvidias RTX Spark steckt bereits in Notebooks, kompakte Desktop-Rechner damit kommen gerade auf den Markt. Wer Windows mit CUDA und gemeinsamem Speicher will, sollte die ersten Modelle und ihre Preise abwarten. Am oberen Ende starten Mini-PCs mit dem neuen Ryzen AI Max+ PRO 495 (Gorgon Halo) und 192 GB bei 5.299 Pfund. Der Bosgame M5 mit dem Vorgänger-Chip Ryzen AI Max+ 395 und 128 GB liegt mit 3.699 € deutlich darunter. Er ist trotzdem nur für Leute sinnvoll, die regelmäßig Modelle der 70B-Klasse nutzen.
Wann ein Mini-PC die falsche Wahl ist
- Du spielst ohnehin: Ein Desktop mit eigener Grafikkarte holt mehr aus deinem Geld heraus.
- Du brauchst nur gelegentlich ein Modell auf Spitzenniveau: Dann fährst du mit einem Abo für Claude Opus 5.5 günstiger als mit 2.599 € für den Apple Mac Studio (M5 Max, 36 GB).
- Dir reichen 16 GB: Der Geekom A5 Pro für 549 € taugt für kleine Modelle wie Gemma 4 E4B, für 27B-Modelle aber nicht.
Unser Tipp
Rechne vor dem Kauf rückwärts: Nimm die Größe der Modellgewichte und plane einige Gigabyte für Kontext und Betriebssystem dazu. Mit 32 GB gemeinsamem Speicher bist du auf der sicheren Seite. Jeder Euro für 64 GB oder mehr lohnt sich erst, wenn du größere Modelle wirklich einsetzen willst.
Häufige Fragen
Die Fragen, die vor dem Kauf am häufigsten auftauchen, kurz beantwortet. Am Ende erklären wir, wie unsere Empfehlungen zustande kommen.
Häufig gestellte Fragen
Wie viel Arbeitsspeicher brauche ich für ein 27B-Modell?
Rechne mit rund 16 GB nur für die Gewichte, wenn du ein Modell wie Qwen 3.8-27B als Q4-Quantisierung lädst. Dazu kommt Platz für den Kontext und für das Betriebssystem. 24 GB reichen knapp. Der Apple Mac mini (M6, 24 GB) startet das Modell, lässt dir aber wenig Luft für lange Dokumente oder parallel laufende Programme. 32 GB sind die sichere Wahl. Der Minisforum UM890 Pro und der GEEKOM IT15 bieten genau das, der Mac Studio (M5 Max) hat mit 36 GB noch etwas Reserve.
Mac oder Windows-PC?
Beim Mac nutzen CPU und GPU denselben Arbeitsspeicher, sodass fast der gesamte RAM dem Modell zur Verfügung steht. Dazu kommt MLX, Apples eigenes Framework für Sprachmodelle. Der Haken: Den Arbeitsspeicher kannst du später nicht erweitern. x86-Geräte wie der GEEKOM IT15 lassen sich nachträglich aufrüsten und laufen in der gewohnten Windows- oder Linux-Umgebung mit llama.cpp, ROCm oder Vulkan. Wenn du ohnehin am Mac arbeitest, ist der Einstieg dort am einfachsten. Wenn deine Werkzeuge unter Windows oder Linux laufen, bleib dabei.
Lohnt sich lokale KI gegenüber der Cloud?
Ja, wenn dir Datenschutz, Offline-Nutzung oder dauerhafte Nutzung ohne Abo-Kosten wichtig sind. Deine Texte und dein Code verlassen den Rechner nicht, und nach dem Kauf zahlst du nur noch Strom. Für die absolute Spitzenleistung bleibt die Cloud vorn: An Claude Opus 5.5 reicht auch Qwen 3.8-27B nicht heran.
Wie entstehen eure Empfehlungen?
Wir werten Herstellerangaben, Fachartikel (unter anderem von heise, ComputerBase und TechRadar) und Erfahrungsberichte von Nutzern aus. Daraus vergleichen wir die Werte, die für lokale KI zählen: Arbeitsspeicher, Preis und Software-Unterstützung. Wenn neue Modelle oder Preise die Lage ändern, passen wir die Empfehlungen an.
Neueste Bewertungen
Ratgeber & Artikel