Apple Mac mini M6 (24 GB, 512 GB): Wie weit kommst du damit bei lokaler KI?
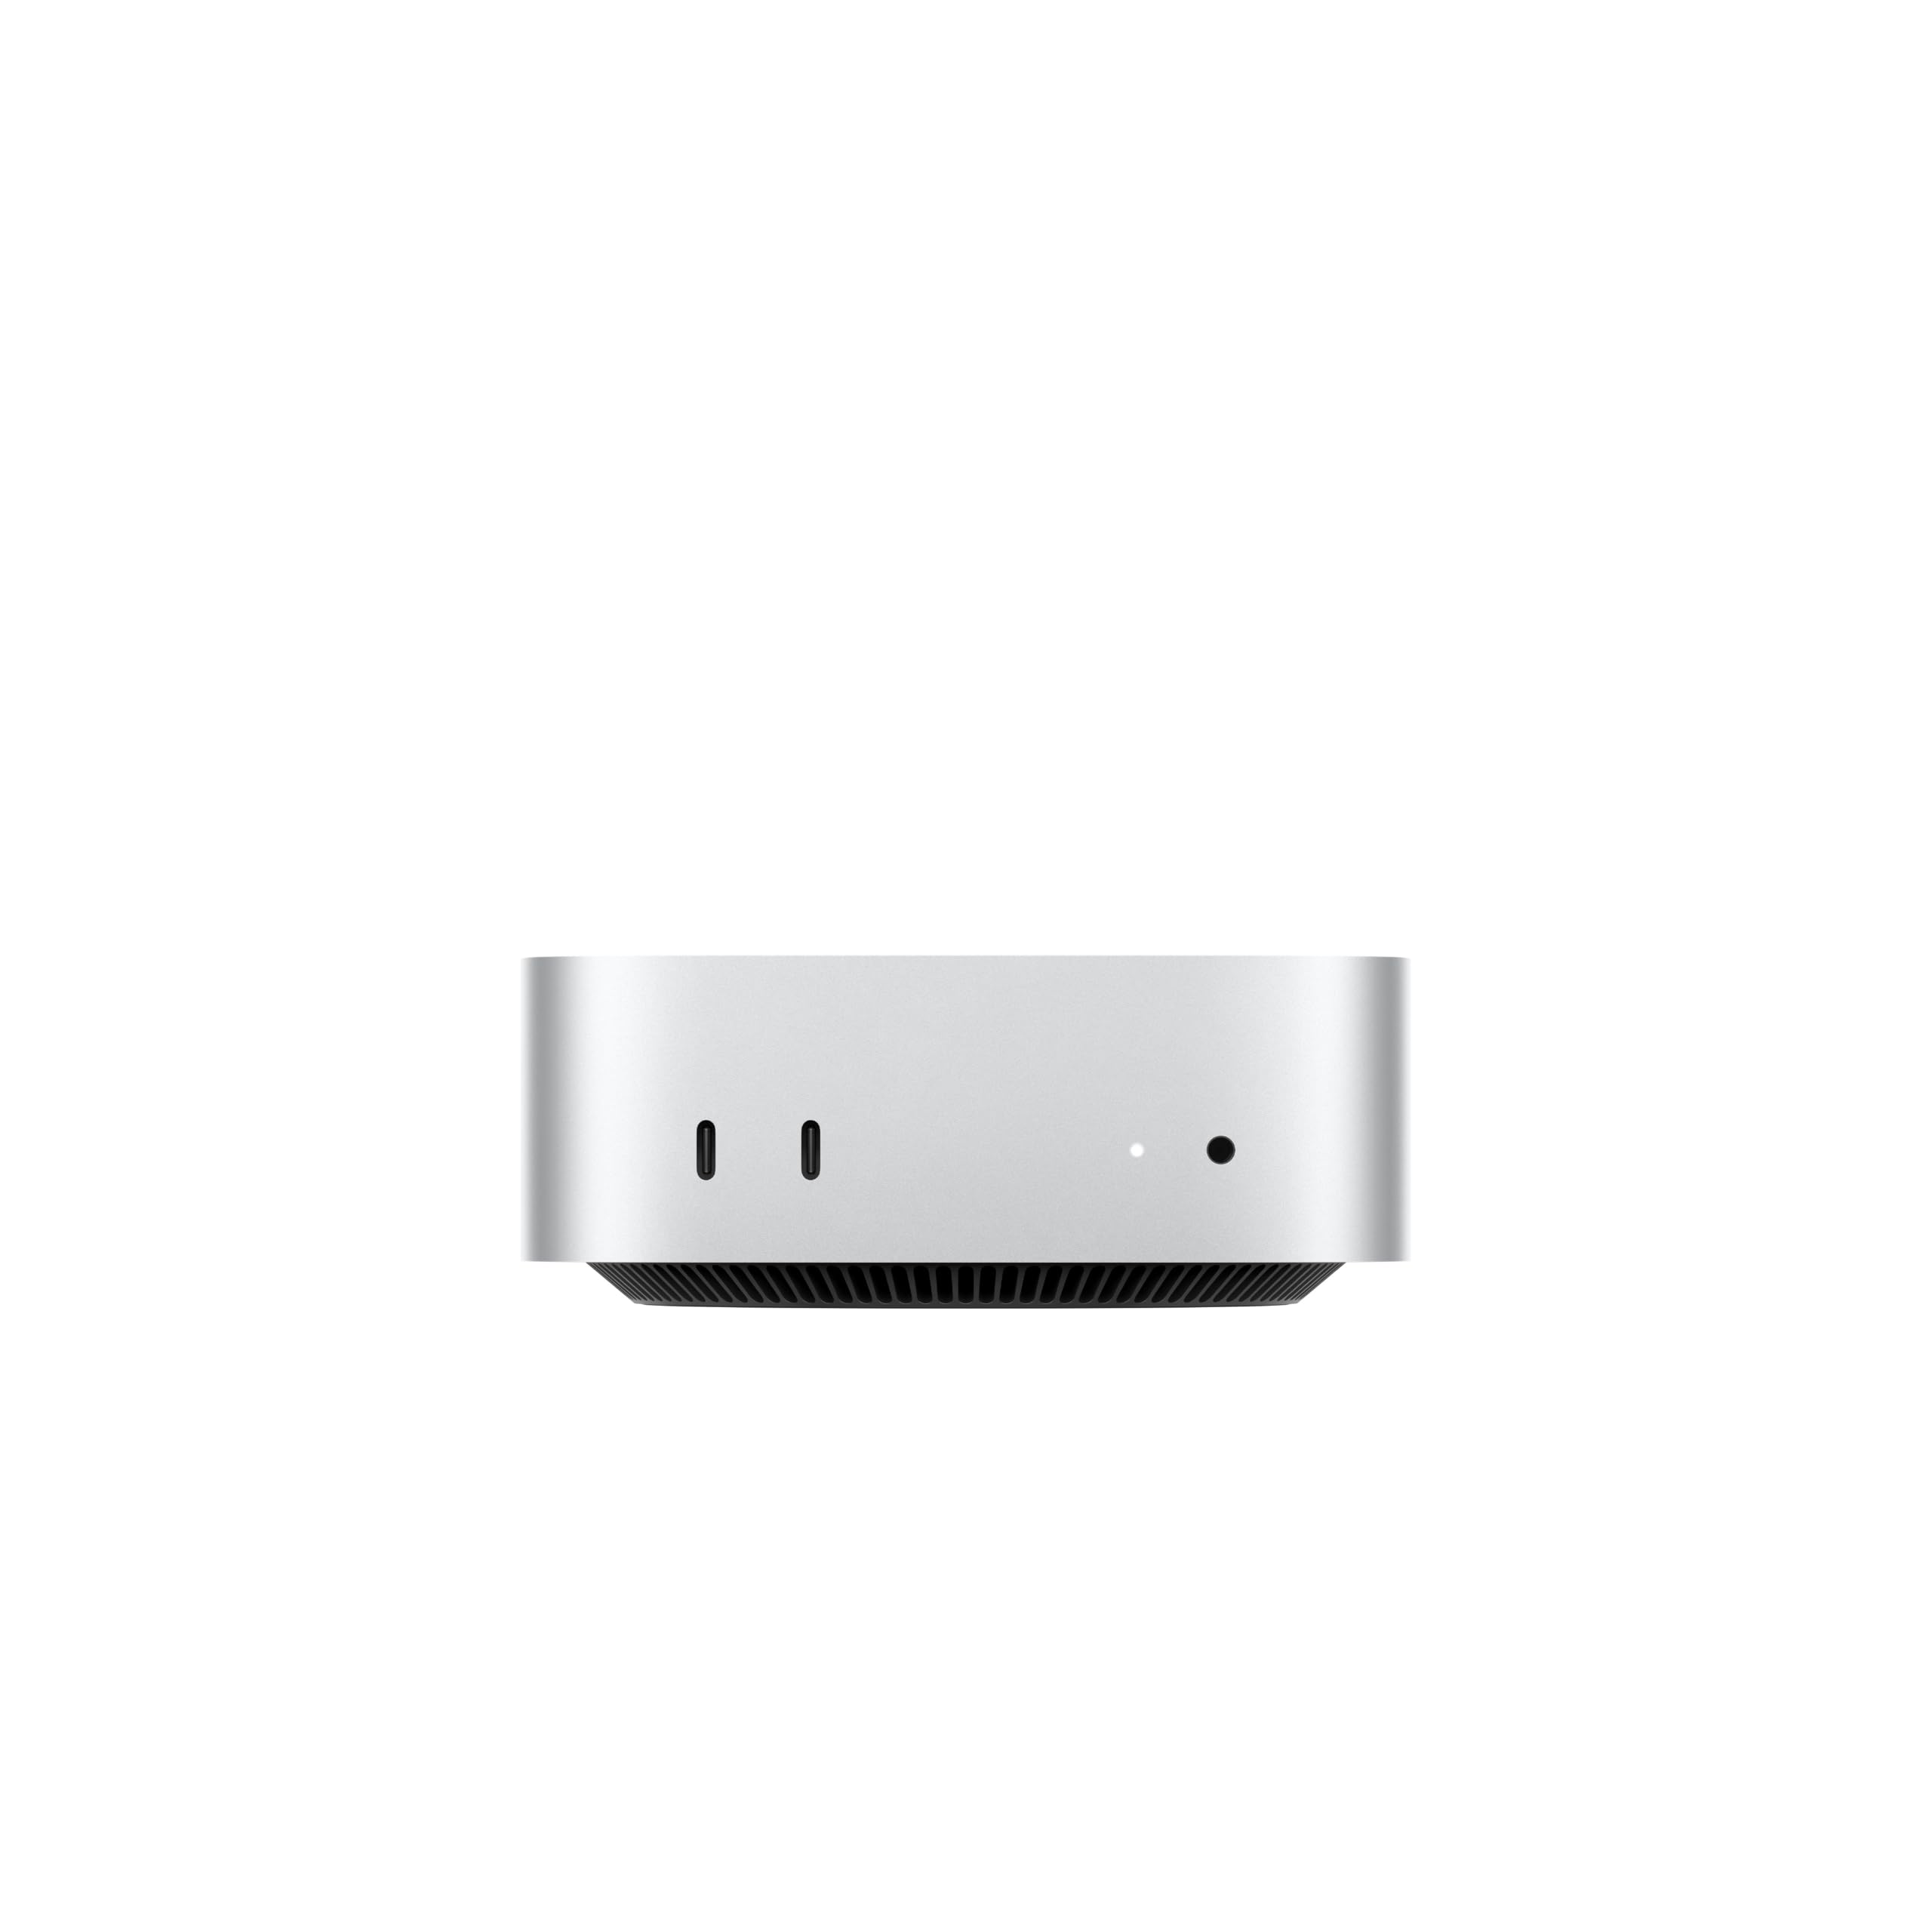

24 GB Unified Memory: Qwen 3.8-27B im 4-Bit-Quant auf dem Schreibtisch
- Configuration
- M6 Chip, 12‑Core CPU und 12‑Core GPU, 24GB Gemeinsamer Arbeitsspeicher, 512 GB
- Prozessor
- Apple M6 12-Core
- Arbeitsspeicher (RAM/VRAM)
- 24 GB
- Speicherbandbreite
- 170 GB/s
- 24 GB: 27B-Modelle als 4-Bit-Quant
- Neural Accelerator pro GPU-Kern beschleunigt KI
- 24 GB: wenig Reserve für langen Kontext
Qwen 3.8-27B, eines der stärksten lokalen Sprachmodelle im November 2026, braucht in Q4 rund 16 GB. Der Mac mini M6 hat 24 GB gemeinsamen Speicher, also passt das Modell hinein. Ob die restlichen 8 GB für macOS, Kontext und deine Apps reichen, entscheidet, ob diese Konfiguration für 1.299 € die richtige für dich ist.
Design und Verarbeitung
Der Mac mini M6 steckt in einem ultrakompakten Aluminiumgehäuse in Silber, das Apple bewusst so klein hält, dass es unter einen Monitor passt. Für lokale KI ist das relevanter, als es klingt: Ein Gaming-PC mit Radeon RX 9070 XT braucht ein Gehäuse für eine lange Zwei- bis Drei-Slot-Grafikkarte. Der Mac mini verschwindet dagegen fast vollständig, obwohl du darauf ein Sprachmodell mit 27 Milliarden Parametern ausführen kannst.
Das Netzteil steckt im Gehäuse, ein externer Netzteil-Klotz fällt weg. Hinter dem Monitor verläuft also nur ein einzelnes Stromkabel.
Anschlüsse dort, wo du sie brauchst
Für einen USB-Stick musst du beim M6 nicht hinter das Gerät greifen: Vorn sitzen zwei USB-C-Anschlüsse und eine Kopfhörerbuchse, hinten die festen Verbindungen wie Thunderbolt, HDMI und Ethernet. Die Aufteilung folgt einer einfachen Regel: Was einmal eingesteckt wird und dort bleibt, kommt nach hinten. Was du täglich an- und absteckst, liegt vorn.
Im Alltag mit lokaler KI zahlt sich das aus. Wenn du ein Modell-Archiv von einer externen SSD kopierst, ein Headset für Spracheingabe anschließt oder kurz ein Smartphone verbindest, erreichst du die Buchsen ohne Umbauen. Welche Anschlüsse genau verbaut sind und was sie leisten, ordnen wir im Abschnitt zu Anschlüssen und Software ein.
| Merkmal | Mac mini M6 (diese Konfiguration) |
|---|---|
| Modellnummer | MHQM4ZD/A |
| Farbe | Silber |
| Chip | Apple M6, 12-Core CPU, 12-Core GPU |
| Arbeitsspeicher | 24 GB Unified Memory (fest verlötet) |
| Speicherplatz | 512 GB SSD (fest verlötet) |
| Anschlüsse vorn | 2× USB-C, Kopfhörer |
| Aufstellung | passt unter einen Monitor |
Die Kehrseite: nichts lässt sich aufrüsten
Die kompakte Bauweise hat einen Preis, und der wiegt für KI-Nutzer schwerer als für alle anderen. Bei der Konfiguration MHQM4ZD/A sind Arbeitsspeicher und SSD fest auf der Platine verlötet. Du kannst weder später RAM-Riegel nachstecken noch die SSD gegen eine größere tauschen. Was du beim Kauf wählst, bleibt für die gesamte Lebensdauer des Geräts.
Bei einem Tower-PC rüstest du Arbeitsspeicher nach, wenn deine Modelle wachsen. Beim Mac mini M6 geht das nicht. Die 24 GB dieser Konfiguration reichen für aktuelle Sprachmodelle bis etwa 27B in Q4-Quantisierung, lassen aber wenig Reserve. Erscheint mit Qwen 4 oder einem Nachfolger von Gemma 4 ein größeres Modell, kannst du nicht mit einem RAM-Upgrade reagieren. Das M6 erlaubt höchstens 32 GB. Wenn du schon beim Kauf damit rechnest, an die Grenze zu stoßen, solltest du die größere Konfiguration jetzt wählen.
Beim Speicherplatz ist das Problem kleiner. Eine externe SSD am Thunderbolt-Anschluss nimmt zusätzliche Modelldateien auf, ohne dass du viel an Komfort verlierst. Beim Arbeitsspeicher gibt es keinen solchen Ausweg: Unified Memory heißt, dass CPU und GPU denselben Speicher nutzen. Wie groß ein Modell sein darf, das du lokal ausführst, legt deshalb allein dieser fest verlötete Speicher fest.
Beim Design gibt es wenig zu kritisieren: Der Mac mini M6 ist einer der unauffälligsten Rechner, mit denen du lokale KI betreiben kannst. Die eigentliche Schwäche liegt nicht in der Verarbeitung. Sie ergibt sich aus dem Bauprinzip, denn ein so kleines Gerät mit verlötetem Speicher verzeiht keine Fehlentscheidung beim Kauf.
Leistung im Alltag und bei lokaler KI
Auf dem Papier ist der M6 ein 12-Core-Chip mit 12-Core-GPU. Für lokale KI sind aber zwei andere Angaben wichtiger: Jeder der zwölf GPU-Kerne hat einen eigenen Neural Accelerator, und dazu kommt eine Dual 16 Core Neural Engine. Apple verteilt KI-Rechenarbeit damit auf drei Ebenen: CPU, GPU mit integrierten Beschleunigern und die separate NPU.
Im Alltag merkst du davon wenig, und das ist positiv gemeint. Browser mit vielen Tabs, Office, Fotobearbeitung und Code-Kompilierung bringen eine 12-Core-CPU nicht an ihre Grenzen. Auch Videoschnitt in Final Cut oder DaVinci Resolve läuft auf einem Apple-Chip dieser Klasse flüssig, solange du nicht täglich lange 8K-Projekte exportierst. Spürbar wird der Unterschied zu älteren Macs erst bei Dauerlast. Und genau die erzeugt lokale KI.
| Eckdaten | Wert | Was das in der Praxis heißt |
|---|---|---|
| CPU | 12 Kerne | Reserven für Alltag, Entwicklung und Tokenizer-Arbeit nebenbei |
| GPU | 12 Kerne, je mit Neural Accelerator | Hier rechnen llama.cpp und MLX die Sprachmodelle |
| Neural Engine | Dual 16 Core | Apple Intelligence und Systemfunktionen, kaum für eigene LLMs |
| Speicherbandbreite | bis zu 170 GB/s | Legt die Obergrenze für Token pro Sekunde fest |
| Arbeitsspeicher | 24 GB Unified Memory | Bestimmt, welche Modellgröße überhaupt hineinpasst |
Warum die Bandbreite wichtiger ist als die Kernzahl
Ein Sprachmodell muss für jedes erzeugte Token seine gesamten aktiven Gewichte einmal aus dem Arbeitsspeicher lesen. Die Speicherbandbreite von bis zu 170 GB/s bestimmt deshalb, wie schnell Text erscheint. Wie viele Rechenkerne der Chip hat, spielt dafür eine kleinere Rolle.
Eine einfache Überschlagsrechnung zeigt das: Ein dichtes Modell mit rund 16 GB Gewichten, etwa Qwen 3.8-27B in Q4-Quantisierung, kann bei 170 GB/s theoretisch höchstens gut 10 Tok/s erreichen. In der Praxis liegt der Wert darunter. Das reicht zum Mitlesen im Chat. Bei langen Code-Antworten wartest du aber spürbar.
Mixture-of-Experts-Modelle sind die Ausnahme. Sie lesen pro Token nur einen kleinen Teil ihrer Gewichte und laufen deshalb bei gleicher Bandbreite deutlich schneller. Welche konkreten Modelle in die 24 GB passen, klären wir im nächsten Abschnitt.
Die Zahl ist eine Herstellerangabe von Apple und nicht unabhängig belegt. Spürbar dürfte sie vor allem bei rechenintensiven Aufgaben werden, die von den Neural Accelerators in den GPU-Kernen profitieren, etwa bei den folgenden.
- die Verarbeitung langer Prompts, also das Einlesen von Code-Dateien oder Dokumenten, bevor die erste Antwort erscheint
- Bildgenerierung
- systemnahe KI-Funktionen wie Apple Intelligence
Die eigentliche Textausgabe Token für Token bleibt durch die Bandbreite begrenzt. Dort ist eher ein Gewinn im Rahmen von Apples Angabe „bis zu 2x schnellerer Speicher“ realistisch, nicht das Fünffache.
Für dich heißt das: Wenn du lokal mit großen Kontexten arbeitest, etwa einem Code-Assistenten, der vor jeder Antwort mehrere tausend Zeilen deines Projekts einliest, profitierst du am meisten vom M6. Die Wartezeit bis zum ersten Token schrumpft deutlich. Die Geschwindigkeit, mit der danach der Text erscheint, steigt weniger stark.
Spanne der hier verglichenen Produkte
Einordnung gegenüber der Konkurrenz
Bei der reinen KI-Geschwindigkeit landet der Mac mini M6 im Mittelfeld. Seine Stärke ist die Balance aus Speichergröße, Bauform und Preis.
Gegen dedizierte Grafikkarten verliert er bei der Bandbreite deutlich. Eine Radeon RX 9070 XT liest ihren Grafikspeicher erheblich schneller, als der M6 mit seinen 170 GB/s auf den gemeinsamen Speicher zugreift. Sie erzeugt Token daher wesentlich schneller, solange das Modell in ihren VRAM passt.
Gegen Mini-PCs mit 8 GiB VRAM gewinnt der Mac. Seine 24 GB Unified Memory stehen der GPU nahezu vollständig zur Verfügung. Ein 27B-Modell passt dort komplett hinein, in einen kleinen Grafikspeicher dagegen nicht.
Die großen Unified-Memory-Maschinen mit 192 GB spielen in einer anderen Liga, kosten aber auch ein Vielfaches.
Der M6 ist also kein Tempo-Monster. Seine Stärke liegt darin, mittelgroße Modelle vollständig im gemeinsamen Speicher auszuführen, in einem Gerät, das unter deinen Monitor passt. Wenn dir die theoretisch höchstens gut 10 Tok/s eines dichten 27B-Modells zu langsam sind, löst ein größerer Arbeitsspeicher das Problem nicht. Dafür bräuchtest du mehr Bandbreite, also einen M5 Pro oder eine dedizierte Grafikkarte.
24 GB Arbeitsspeicher: Was lokal wirklich läuft
Bei lokaler KI entscheidet der Arbeitsspeicher, welche Modelle du laden kannst. Die Rechenleistung bestimmt nur, wie schnell sie laufen. Beim Mac mini M6 teilen sich CPU, GPU und Neural Engine die 24 GB als Unified Memory. Davon geht aber ein Teil an macOS, den Browser und deine übrigen Apps. Für das Sprachmodell bleibt deutlich weniger als die Zahl auf dem Karton.
Qwen 3.8-27B: läuft, aber ohne Reserve
Das derzeit spannendste Modell in dieser Größenklasse ist Qwen 3.8-27B. Laut heise schlägt es in mehreren Benchmarks Claude Opus 4.6, das im Februar 2026 noch als führendes Cloud-Modell galt. Als Unsloth-GGUF in der Quantisierung UD-Q4KXL (etwa 4 Bit) belegen die Gewichte rund 16 GB. In llama.cpp läuft das auf dem Mac mini M6. Allerdings bleiben dann nur noch rund 8 GB für macOS, deine Apps und den Kontextspeicher (KV-Cache) übrig.
Der KV-Cache wächst mit jedem Token im Kontext. Qwen 3.8-27B beherrscht nativ 262.144 Token, und per YaRN ließ es sich auf 512K erweitern. Das gelang allerdings auf einem MacBook Pro M5 mit 128 GB. Auf 24 GB nutzt du davon nur einen Bruchteil. Für einen Code-Assistenten, der einzelne Dateien oder Funktionen bearbeitet, reicht das. Wer ein ganzes Repository in den Kontext laden und nebenbei Xcode, Docker und 30 Browser-Tabs offen haben will, stößt an die Grenze. macOS lagert dann auf die SSD aus, und die Token pro Sekunde brechen spürbar ein.
Gemma 4: die entspanntere Wahl
Googles Gemma 4 passt besser zu 24 GB. Das 12B-Modell braucht in Q4 grob die Hälfte des Speichers von Qwen 27B. Es ist multimodal, versteht also auch Bilder und Audio, und lässt viel Platz für Kontext und andere Programme. Das 26B A4B ist ein Mixture-of-Experts-Modell: Pro Token rechnet es nur mit etwa 4 Milliarden aktiven Parametern. Weil die 170 GB/s Speicherbandbreite die Geschwindigkeit begrenzen, liefert es deutlich mehr Token pro Sekunde als ein gleich großes, dichtes Modell. Beide Varianten stehen unter Apache 2.0 und bieten bis zu 256K Kontext. Das größere 31B ist auf 24 GB dagegen kaum sinnvoll, weil es noch mehr Speicher braucht als Qwen 27B.
| Modell | Quantisierung | Einschätzung für 24 GB |
|---|---|---|
| Gemma 4 12B | Q4 | bequem, viel Platz für Kontext und Apps |
| Gemma 4 26B A4B (MoE) | Q4 | passt gut, flott dank nur 4B aktiven Parametern |
| Qwen 3.8-27B | UD-Q4KXL, ca. 16 GB | läuft, aber kaum Luft für langen Kontext |
| Gemma 4 31B | Q4 | zu knapp für den Alltag |
| 70B-Modelle | Q4 | passen nicht |
Profi-Tipp
Am schnellsten probierst du Gemma 4 mit Docker aus: docker model pull gemma4 lädt das Modell direkt von Docker Hub. Für Qwen 3.8-27B nimmst du llama.cpp mit dem Unsloth-GGUF. Schließ vor langen Sitzungen speicherhungrige Apps wie Chrome oder virtuelle Maschinen. Jedes freie Gigabyte geht direkt in den Kontext.
Wo die Grenze liegt und warum sie endgültig ist
Der M6 unterstützt höchstens 32 GB. Mehr geht in diesem Gehäuse nicht, und nachrüsten kannst du später ebenfalls nicht, weil der Arbeitsspeicher fest verlötet ist. 32 GB bringen dir bei Qwen 27B spürbar mehr Kontext, aber kein 70B-Modell. Dafür brauchst du einen Mac mini mit M5 Pro oder gleich einen Mac Studio, der mit bis zu 512 GB konfigurierbar ist. Mehrere Mac Studios lassen sich sogar per Thunderbolt 5 RDMA koppeln. Preislich ist das aber eine ganz andere Klasse.
Bleib bei den Erwartungen realistisch: Lokale Modelle liegen laut heise etwa ein halbes Jahr hinter den Cloud-Spitzenmodellen wie Claude Opus 5.5. Ein Qwen 3.8-27B auf deinem Schreibtisch erreicht also ungefähr das Niveau, das Anfang 2026 die Cloud-Spitze war. Dafür bleiben deine Daten vollständig lokal, und du zahlst keine Abo- oder API-Kosten. Für Code-Vervollständigung, Zusammenfassungen und Dokumentenarbeit reicht das mit 24 GB gut. Wer täglich mit 27B-Modellen und langen Kontexten arbeitet, sollte beim Kauf zu 32 GB greifen. Das ist die einzige Stelle, an der du später nicht mehr nachbessern kannst.
Anschlüsse, Bedienung und Software
Für ein Gerät dieser Größe ist die Ausstattung großzügig. Hinten sitzen drei Thunderbolt-4-Anschlüsse, HDMI und 2,5-Gbit-Ethernet. Vorn findest du zwei USB-C-Anschlüsse und einen Kopfhöreranschluss. Insgesamt steuert der Mac mini M6 bis zu drei externe Displays an. Für ein Entwickler-Setup mit zwei Monitoren bleibt also ein Ausgang frei, ohne dass du ein Dock brauchst.
| Position | Anschlüsse | Typischer Einsatz |
|---|---|---|
| Rückseite | 3× Thunderbolt 4, 1× HDMI, 1× 2,5-Gbit-Ethernet | Monitore, externe SSD, NAS oder Heimserver |
| Vorderseite | 2× USB-C, 1× Kopfhörer | USB-Sticks, Kartenleser, Headset |
| Drahtlos | WLAN 7, Bluetooth 6 (Apple N1-Chip) | Netzwerk, Tastatur, Maus, Kopfhörer |
Das 2,5-Gbit-Ethernet bringt bei lokaler KI einen handfesten Vorteil. Liegen deine Modelle auf einem NAS, lädst du ein 16-GB-Modell spürbar schneller als über klassisches Gigabit. Drahtlos setzt Apple auf den hauseigenen N1-Chip mit WLAN 7 und Bluetooth 6. WLAN 7 bringt dir aber nur dann mehr Tempo, wenn auch dein Router den Standard beherrscht. Eine Einschränkung gibt es: Der M6 hat Thunderbolt 4, nicht Thunderbolt 5. Mehrere Macs per Thunderbolt-5-RDMA zu einem Rechenverbund zu koppeln, bleibt deshalb den Pro- und Studio-Modellen vorbehalten.
Der eigentliche Engpass: 512 GB SSD
Der Arbeitsspeicher entscheidet, welche Modelle laufen. Die SSD entscheidet, wie viele davon du griffbereit hast. Allein Qwen 3.8-27B in der Quantisierung UD-Q4KXL belegt rund 16 GB. Dazu kommen schnell Gemma 4 in zwei, drei Größen, eine zweite Quantisierung zum Vergleich und ein paar Bildmodelle wie Flux.2. Ziehst du von den 512 GB noch macOS, Apps und deine eigenen Daten ab, wird es eng.
Hinzu kommt ein typischer Stolperstein. Jedes Werkzeug verwaltet seine Modelle selbst. Ein per docker model pull geladenes Gemma 4 liegt getrennt von derselben Datei in LM Studio oder im llama.cpp-Ordner. Wer verschiedene Werkzeuge ausprobiert, hat dasselbe Modell schnell zwei- oder dreimal auf der Platte.
Eine externe Thunderbolt-SSD ist deshalb fast Pflicht. Thunderbolt 4 überträgt bis zu 40 Gbit/s, und eine NVMe-SSD im passenden Gehäuse lädt Modelle damit so schnell, dass du im Alltag kaum einen Unterschied zur internen SSD merkst. Die Datei muss ohnehin nur einmal in den gemeinsamen Speicher geladen werden. Danach bestimmen der Arbeitsspeicher und die Bandbreite das Tempo, nicht die SSD. Rechne die externe SSD gleich in dein Budget ein, denn die interne lässt sich später nicht tauschen.
macOS: KI ab Werk, lokale Modelle als Ergänzung
Ab Werk bringt macOS Apple Intelligence und Siri AI mit. Beide helfen dir beim Formulieren von Texten, beim Zusammenfassen und bei Alltagsaufgaben. Sie ersetzen aber kein frei wählbares Sprachmodell, das du selbst steuerst. Für Code-Assistenten oder vertrauliche Dokumente greifst du weiter zu llama.cpp, LM Studio oder Docker. Diese Werkzeuge nutzen auf Apple Silicon die GPU direkt über Metal.
Bei der Bedienung punktet macOS mit der Fensteranordnung. Damit legst du Editor, Terminal und Chat-Oberfläche sauber nebeneinander. Mit Sidecar wird ein iPad zum zusätzlichen Bildschirm, praktisch etwa für ein Monitoring-Fenster mit der Auslastung des Arbeitsspeichers. Besitzt du ein iPhone, kommt die enge Verzahnung hinzu. Du kopierst etwas auf dem iPhone und setzt es am Mac ein, beantwortest Nachrichten über die Nachrichten-App und nimmst FaceTime-Anrufe direkt am Mac an.
Gerade für ein Gerät ohne eingebauten Bildschirm, Lautsprecher und Mikrofon wiegt dieser Komfort einiges. Wer dagegen in der Windows-Welt arbeitet, verliert diesen Vorteil. Er muss sich zudem an einige macOS-Eigenheiten gewöhnen, etwa beim Umgang mit Python-Umgebungen.
Im Vergleich zu den Alternativen
| Produkt | Bewertung | Preis | Kaufen |
|---|---|---|---|
 Nvidia GeForce RTX 5090 32 GB GDDR7 an 512 Bit: 27B-Modelle wie Qwen 3.8 laufen komplett im VRAM +32 GB VRAM: 27B-Modelle samt Kontext+512 Bit: zügigere Token-Ausgabe -Preis weit über der RX 9070 XT | 9.995,00 € | Kaufen → | |
 Apple Mac Studio (M5 Max, 36 GB) 36 GB Unified Memory für 27B-Modelle wie Qwen 3.8 – leise auf dem Schreibtisch +36 GB: Qwen 3.8-27B passt komplett+Neural Accelerator je GPU-Kern -36 GB verlötet, später nicht aufrüstbar | 2.599,00 € | Kaufen → | |
 Bosgame M5 (Ryzen AI Max+ 395, 128 GB, 2 TB) 128 GB Unified Memory im Mini-PC: Platz für große lokale LLMs +128 GB Unified Memory für große LLMs+Radeon 8060S: Bildgenerierung ohne Grafikkarte -RAM verlötet, später nicht aufrüstbar | 3.699,00 € | Kaufen → | |
 Apple Mac mini (M5 Pro, 24 GB, 512 GB) Top-Empfehlung 24 GB Unified Memory und 307 GB/s: lokale 27B-Modelle in einem 12,7-cm-Würfel +24 GB: 27B-Modelle als 4-Bit-Quant+307 GB/s: zügigere Token-Ausgabe -24 GB: wenig Puffer für Langkontext | 1.699,00 € | Kaufen → | |
| Apple Mac mini (M6, 24 GB, 512 GB) 24 GB Unified Memory: Qwen 3.8-27B im 4-Bit-Quant auf dem Schreibtisch +24 GB: 27B-Modelle als 4-Bit-Quant+Neural Accelerator pro GPU-Kern beschleunigt KI -24 GB: wenig Reserve für langen Kontext | 1.299,00 € | Kaufen → | |
 GEEKOM IT15 (Core Ultra 9 285H, 32 GB, 1 TB) Core Ultra 9 285H und 32 GB DDR5: kompakter Einstieg für kleine lokale KI-Modelle +Zwei SODIMM-Slots: RAM später aufrüstbar+Zweiter M.2-Slot für Modellbibliothek -Keine eigene GPU: größere LLMs laufen zäh | 1.399,00 € | Kaufen → |
Preise vom 16. Nov. 2026, sie können sich inzwischen geändert haben.
Vorteile
- 24 GB: 27B-Modelle als 4-Bit-Quant
- Neural Accelerator pro GPU-Kern beschleunigt KI
- Kompaktes Gehäuse passt unter jeden Monitor
- 2,5-Gbit-Ethernet: Modelle schnell aus dem NAS
- Drei Thunderbolt 4 für externe SSDs
Nachteile
- 24 GB: wenig Reserve für langen Kontext
- Maximal 32 GB, kein Upgrade nachträglich
- 512 GB SSD füllt sich mit Modellen
Für wen sich der Mac mini M6 eignet
Der Mac mini M6 mit 24 GB Arbeitsspeicher und 512 GB SSD ist kein Allrounder für jede KI-Ambition. Er ist ein sehr guter Mini-PC für eine klar umrissene Gruppe. Entscheidend ist, wie groß die Sprachmodelle sind, die du lokal ausführen willst, und ob du nebenbei spielen oder Bilder generieren möchtest.
Passt zu
- Entwicklern mit lokalem Code-Assistenten: Qwen 3.8-27B in Q4 belegt rund 16 GB und läuft per llama.cpp. Gemma 4 12B oder 26B A4B passen mit mehr Reserve. Dein Quellcode verlässt den Rechner nicht.
- iPhone-Nutzern: Text auf dem iPhone kopieren und am Mac einfügen, Nachrichten senden und FaceTime-Anrufe annehmen funktioniert ohne Einrichtung.
- Büro und Medienbearbeitung auf wenig Platz: Das Gerät passt unter den Monitor, unterstützt bis zu drei externe Displays und hat USB-C und Kopfhörer vorn.
Passt nicht zu
- Nutzern von 70B-Modellen oder sehr langen Kontexten: Schon in 4-Bit-Quantisierung übersteigen sie die 24 GB, und mehr als 32 GB erlaubt das M6 nicht.
- Ernsthaften Spielern: Ein PC mit Grafikkarte wie der Radeon RX 9070 XT ist dafür die bessere Wahl.
- Nutzern lokaler Bildgenerierung mit Flux.2: Große Bildmodelle brauchen viel Speicher, und der ist hier knapp.
Entwickler: der eigentliche Zielkunde dieser Konfiguration
Wer einen Code-Assistenten offline betreiben will, etwa wegen Kundencode, NDA-Projekten oder schlicht aus Datenschutzgründen, bekommt mit dieser Konfiguration den günstigsten sinnvollen Einstieg. Qwen 3.8-27B bringt genug Qualität für Code-Vervollständigung, Refactoring und Erklärungen mit. Neben dem Modell müssen sich aber IDE, Browser und Kontextspeicher die knappe Reserve teilen. Parallel ein schweres Xcode-Projekt bauen und dem Modell ein großes Repository als Kontext geben, das wird eng.
Bequemer wird es mit Gemma 4: Die 12B-Variante und das MoE-Modell 26B A4B lassen dir mehr Luft, und wenn du ohnehin mit Docker arbeitest, musst du kaum etwas umstellen. Die 2,5-Gbit-Ethernet-Buchse hilft, wenn du Modelle von einem NAS lädst, statt die 512 GB SSD zu füllen.
Büro, Medien und Apple-Haushalte
Für Office, Fotobearbeitung und Videoschnitt in Full HD oder 4K ist der Mac mini M6 auf einem kleinen Schreibtisch eine kompakte Lösung. Mit drei Thunderbolt-4-Anschlüssen, HDMI und Ethernet ersetzt er einen Tower, ohne dass dir Buchsen fehlen. Am meisten profitierst du, wenn schon ein iPhone in deiner Tasche steckt: Die Zusammenarbeit mit dem Mac ist der Grund, warum viele beim Mac bleiben, und zwar mehr als jede Benchmark-Zahl.
Wer lieber verzichten sollte
Große Modelle und lange Kontexte sind die harte Grenze. Ein 70B-Sprachmodell braucht schon in Q4 deutlich mehr als 32 GB, und das ist das Maximum, das das M6 überhaupt zulässt. Dasselbe gilt für Qwen 3.8-27B mit sehr langem Kontext: Die per YaRN erweiterten 512K-Token liefen auf einem Rechner mit mehr als fünfmal so viel Unified Memory. Wer in diese Richtung will, landet beim Mac mini mit M5 Pro, beim Mac Studio oder bei Systemen wie dem GMKtec EVO-X5 Pro mit 192 GB.
Spieler sind mit einem Windows-PC besser bedient. Ein normaler Gaming-PC mit einer Radeon RX 9070 XT für etwa 920 € taugt laut heise zudem für sinnvolle lokale KI-Arbeit, sogar fürs Programmieren.
Auch lokale Bildgenerierung mit Flux.2, Krea-2 oder Z-Image ist nicht die Stärke dieser Konfiguration. Schon bei knappem Grafikspeicher setzt PCGH auf abgespeckte Turbo-Versionen in FP8 oder BF16, die in ComfyUI laufen. Auf 24 GB, die sich das Bildmodell zudem mit dem System teilen muss, bleibt dafür wenig Spielraum.
Faustregel für die Kaufentscheidung
Wenn dein größtes geplantes Modell unter etwa 16 GB bleibt und du nicht spielen willst, reichen die 24 GB. Planst du 27B-Modelle mit viel Kontext oder mehrere Modelle gleichzeitig, nimm direkt 32 GB. Nachrüsten lässt sich der Arbeitsspeicher später nicht.
Fazit
Der Mac mini M6 mit 24 GB und 512 GB ist ein sehr ausgewogener Allround-Mini-PC. Er ist kompakt, hat Anschlüsse vorn und bietet mit dem Unified Memory eine Architektur, die für lokale KI besser geeignet ist als Windows-Mini-PCs mit kleinem Grafikspeicher. Tom's Guide führt den Mac mini M6 derzeit als Empfehlung Nummer eins unter den Mini-PCs. Die Konfiguration MHQM4ZD/A kostet 1.299 € und damit 250 € mehr als der Einstieg ab 1.049 €. Für lokale KI zählt dabei vor allem der Arbeitsspeicher. Prüf also vor dem Kauf genau, wie viel davon die günstigere Variante mitbringt.
Für Alltag, Entwicklung und mittelgroße Sprachmodelle ist der Mac mini M6 mit 24 GB die ausgewogenste Wahl auf dem Schreibtisch. Bei lokaler KI setzen dir die fest verlöteten 24 GB aber eine klare Obergrenze, die du schon beim Kauf einplanen musst.
Wo die 24 GB reichen und wo nicht
Die ehrliche Einschränkung betrifft den Arbeitsspeicher. Qwen 3.8-27B in der Quantisierung UD-Q4KXL belegt rund 16 GB. Das Modell passt in die 24 GB und taugt als lokaler Code-Assistent, lässt für macOS, deine Programme und den Kontextspeicher aber nur etwa 8 GB frei. Lange Kontexte und mehrere parallel geladene Modelle sind damit nicht drin. Deutlich entspannter läuft Gemma 4 in den Größen 12B und 26B A4B (MoE). Dazu kommt die Speicherbandbreite von bis zu 170 GB/s: Sie begrenzt die Token pro Sekunde bei großen dichten Modellen. Ein 27B-Modell läuft also zuverlässig, aber nicht rasend schnell.
Hinzu kommt der Zeitfaktor: Qwen 4 steht bereits in den Startlöchern. Neue Modellgenerationen werden kaum kleiner. Weil sich RAM und SSD beim Mac mini nicht nachrüsten lassen, kaufst du mit dem Arbeitsspeicher auch gleich die Lebensdauer des Geräts für KI-Aufgaben.
Die eigentliche Kaufentscheidung: welche RAM-Stufe?
| Arbeitsspeicher | Was lokal sinnvoll läuft | Passt zu dir, wenn … |
|---|---|---|
| 24 GB (M6, diese Konfiguration) | Gemma 4 12B und 26B A4B bequem, Qwen 3.8-27B in Q4 mit wenig Reserve | du mittelgroße Modelle für Code, Texte und Recherche nutzen willst und meist nur ein Modell gleichzeitig lädst |
| 32 GB (M6, Maximum) | Qwen 3.8-27B mit spürbar mehr Luft für Kontext und Programme nebenher | du täglich mit 27B-Modellen arbeitest und das Gerät mehrere Modellgenerationen lang nutzen willst |
| Mac mini mit M5 Pro | größere Modelle und längere Kontexte, höhere Speicherbandbreite | du an die 32-GB-Grenze des M6 stößt, aber keinen Mac Studio oder Rechner wie den GMKtec EVO-X5 Pro kaufen willst |
Wenn du mit 27B-Modellen arbeiten willst, lohnt sich der Schritt auf 32 GB meist mehr als eine größere SSD. Speicherplatz kannst du über ein externes Thunderbolt-Laufwerk günstig ergänzen, Arbeitsspeicher dagegen nie. Für 70B-Modelle oder sehr lange Kontexte ist das M6 mit seinem Maximum von 32 GB grundsätzlich die falsche Plattform. Dafür sind ein M5 Pro, ein Mac Studio oder ein Rechner wie der GMKtec EVO-X5 Pro mit 192 GB Unified Memory gedacht, die allerdings in einer ganz anderen Preisliga spielen.
Kurz gesagt
Nimm die 24-GB-Version, wenn der Mac mini vor allem dein leiser Alltags- und Entwicklungsrechner ist und lokale KI mit Modellen bis 27B dazugehört. Greif zu 32 GB, wenn lokale Sprachmodelle der Hauptgrund für den Kauf sind. Und schau dir den M5 Pro an, wenn du schon heute weißt, dass dir 27B auf Dauer nicht reichen wird.
Unterm Strich bekommst du mit dieser Konfiguration einen kompakten Rechner, der dich ohne Bastelaufwand in die lokale KI einführt. Wichtig ist nur, dass du die RAM-Frage vor dem Kauf ehrlich beantwortest, denn nachträglich lässt sie sich nicht mehr korrigieren.