Unified Memory oder Grafikkarte: Welche Architektur passt zu lokaler KI?
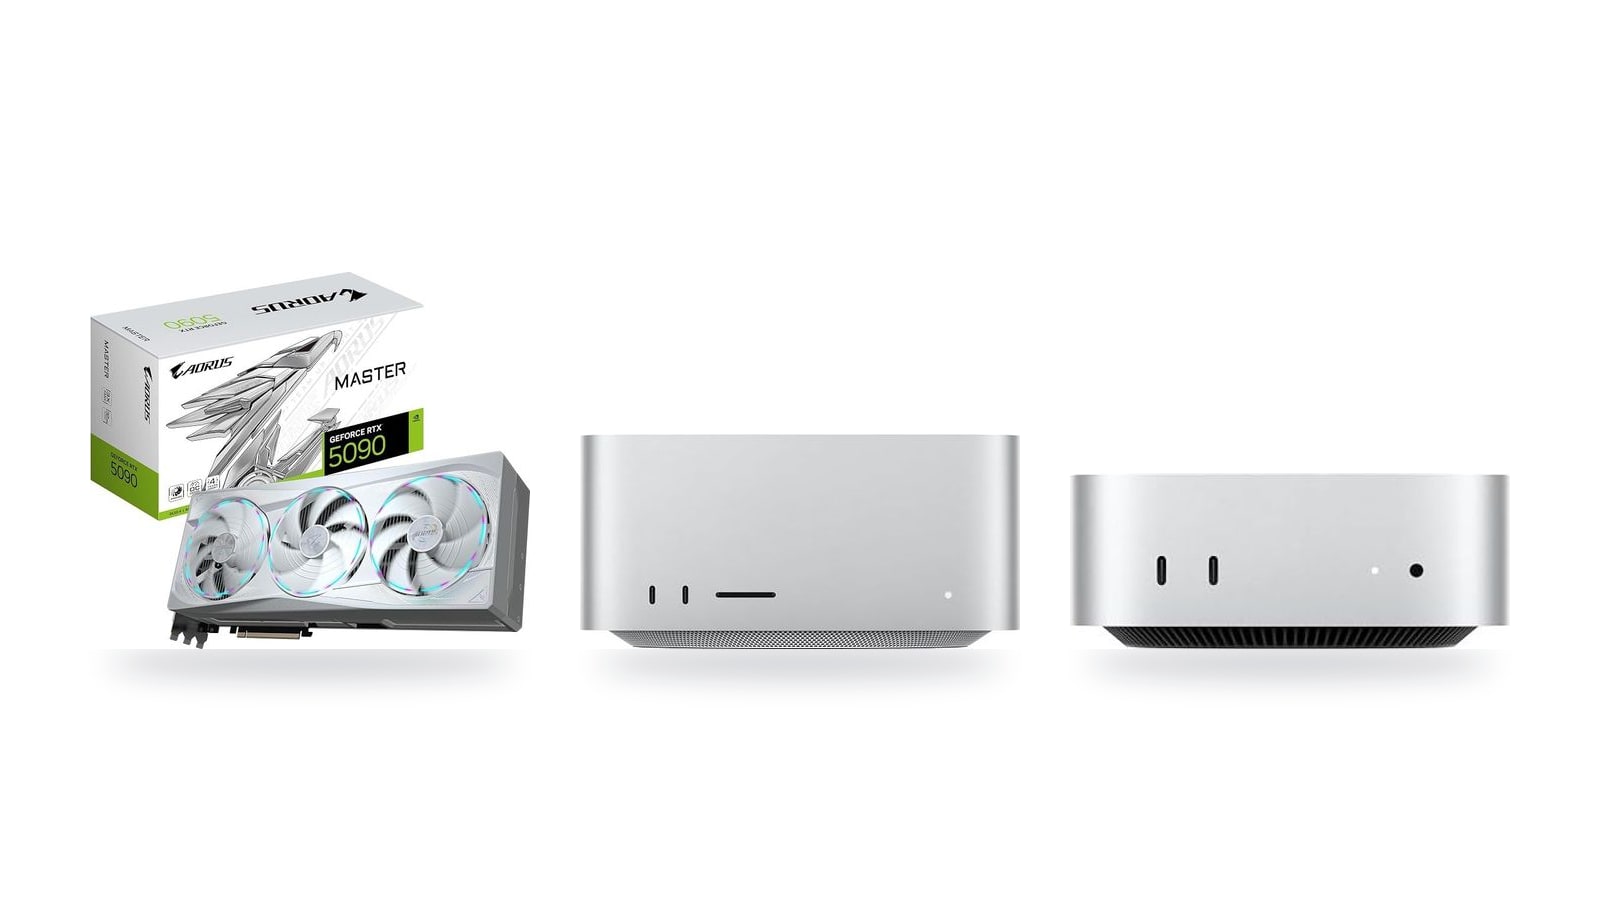
Qwen 3.8-27B schlägt in mehreren Benchmarks Claude Opus 4.6, das führende Cloud-Modell vom Februar 2026, und braucht dafür nur rund 16 GB. Ob es bei dir mit sehr langem Kontext oder nur gerade so läuft, hängt deshalb weniger von der Rechenleistung ab als davon, wo und wie viel Speicher deine Hardware für die KI freigibt.
Die Kandidaten auf einen Blick
| Produkt | Bewertung | Preis | Kaufen |
|---|---|---|---|
 Nvidia GeForce RTX 5090 32 GB GDDR7 an 512 Bit: 27B-Modelle wie Qwen 3.8 laufen komplett im VRAM +32 GB VRAM: 27B-Modelle samt Kontext+512 Bit: zügigere Token-Ausgabe -Preis weit über der RX 9070 XT | 9.995,00 € | Kaufen → | |
 Apple Mac Studio (M5 Max, 36 GB) 36 GB Unified Memory für 27B-Modelle wie Qwen 3.8 – leise auf dem Schreibtisch +36 GB: Qwen 3.8-27B passt komplett+Neural Accelerator je GPU-Kern -36 GB verlötet, später nicht aufrüstbar | 2.599,00 € | Kaufen → | |
 Bosgame M5 (Ryzen AI Max+ 395, 128 GB, 2 TB) 128 GB Unified Memory im Mini-PC: Platz für große lokale LLMs +128 GB Unified Memory für große LLMs+Radeon 8060S: Bildgenerierung ohne Grafikkarte -RAM verlötet, später nicht aufrüstbar | 3.699,00 € | Kaufen → | |
 Apple Mac mini (M5 Pro, 24 GB, 512 GB) Top-Empfehlung 24 GB Unified Memory und 307 GB/s: lokale 27B-Modelle in einem 12,7-cm-Würfel +24 GB: 27B-Modelle als 4-Bit-Quant+307 GB/s: zügigere Token-Ausgabe -24 GB: wenig Puffer für Langkontext | 1.699,00 € | Kaufen → | |
| Apple Mac mini (M6, 24 GB, 512 GB) 24 GB Unified Memory: Qwen 3.8-27B im 4-Bit-Quant auf dem Schreibtisch +24 GB: 27B-Modelle als 4-Bit-Quant+Neural Accelerator pro GPU-Kern beschleunigt KI -24 GB: wenig Reserve für langen Kontext | 1.299,00 € | Kaufen → | |
 GEEKOM IT15 (Core Ultra 9 285H, 32 GB, 1 TB) Core Ultra 9 285H und 32 GB DDR5: kompakter Einstieg für kleine lokale KI-Modelle +Zwei SODIMM-Slots: RAM später aufrüstbar+Zweiter M.2-Slot für Modellbibliothek -Keine eigene GPU: größere LLMs laufen zäh | 1.399,00 € | Kaufen → |
Preise vom 16. Nov. 2026, sie können sich inzwischen geändert haben.
Warum Sprachmodelle vor allem Speicher brauchen
Ein Sprachmodell (LLM) besteht im Kern aus Milliarden Zahlen, den Gewichten. Damit es antworten kann, müssen diese Gewichte komplett im schnellen Speicher liegen, und zwar im Arbeitsspeicher oder im Grafikspeicher. Ein Modell, das nicht hineinpasst, startet entweder gar nicht oder muss Teile auf langsameren Speicher auslagern und wird dadurch unbrauchbar zäh. Bevor du über Rechenleistung nachdenkst, solltest du deshalb klären, wie viel Platz die Hardware überhaupt bietet.
Unified Memory und VRAM: zwei Bauweisen
Bei Unified Memory teilen sich CPU und GPU einen gemeinsamen Arbeitsspeicher. Ein Mac mini (M6, 24 GB) kann so einen großen Teil seiner 24 GB für das Modell nutzen, ohne Daten zwischen zwei Speicherbereichen hin- und herkopieren zu müssen. Dasselbe Prinzip steckt in AMDs Halo-Chips und Nvidias RTX Spark.
Der Grafikspeicher (VRAM) sitzt dagegen getrennt direkt auf der Grafikkarte. Er ist sehr schnell angebunden, seine Größe ist aber fest verlötet. Die Nvidia GeForce RTX 5090 bringt 32 GB GDDR7 mit, und mehr wird es nie. Auch 128 GB Arbeitsspeicher im PC ändern daran nichts, denn alles, was über die 32 GB hinausgeht, läuft über den deutlich langsameren Systemspeicher.
| Merkmal | Unified Memory | Grafikspeicher (VRAM) |
|---|---|---|
| Wer nutzt ihn? | CPU und GPU gemeinsam | Nur die Grafikkarte |
| Kapazität | Groß, je nach Konfiguration | Fest, bei der RTX 5090 32 GB |
| Stärke | Große Modelle, langer Kontext | Hohes Tempo pro GB |
| Grenze | Bandbreite meist niedriger | Modell muss komplett hineinpassen |
Praxisbeispiel: Qwen 3.8-27B
Wie viel Speicher ein aktuelles Modell braucht, zeigt Qwen 3.8-27B. Seine Gewichte belegen rund 16 GB. Als Unsloth-Quantisierung UD-Q4KXL (etwa 4 Bit pro Gewicht) läuft es in llama.cpp, zusätzlich beschleunigt durch MTP Speculative Decoding. Dabei schlägt das Modell mehrere Token im Voraus vor und prüft sie anschließend in einem Durchgang. Das bringt mehr Tempo, ohne die Qualität der Antworten zu verändern.
Spannend wird es beim Kontext. Nativ verarbeitet das Modell 262.144 Token. Per YaRN wurde dieses Fenster auf 512K erweitert, und zwar auf einem MacBook Pro M5 mit 128 GB Unified Memory. Dafür braucht es so viel Speicher, weil das Modell für jedes Token im Kontext Zwischenergebnisse im sogenannten KV-Cache ablegt. Bei sehr langem Kontext wird dieser Cache größer als das Modell selbst. Die 16 GB Gewichte sind dann nur noch der kleinere Posten.
- 16 GBGewichte von Qwen 3.8-27B in 4-Bit-Quantisierung, die Mindestmenge an freiem Speicher
- 262.144 Tokennativer Kontext des Modells, genug für umfangreiche Codebasen oder lange Dokumente
- 512K TokenKontext nach YaRN-Erweiterung, nur mit sehr viel Speicher machbar
- 32 GBfester Grafikspeicher der RTX 5090, die Obergrenze für Modell und KV-Cache zusammen
Daraus folgt eine einfache Rechnung: In 24 GB Unified Memory passt Qwen 3.8-27B, für langen Kontext bleibt aber wenig Puffer. Bei 32 GB VRAM ist mehr Luft, wer jedoch Hunderttausende Token Kontext nutzen will, landet schnell bei Konfigurationen mit 128 GB, wie sie etwa der Bosgame M5 mitbringt.
Kapazität entscheidet über das Ob, Bandbreite über das Wie schnell
Für jedes erzeugte Token muss der Chip die gesamten aktiven Gewichte einmal aus dem Speicher lesen. Bei Qwen 3.8-27B sind das rund 16 GB pro Token. Die Speicherbandbreite in GB/s legt deshalb eine harte Obergrenze für die Token pro Sekunde fest. Grob gerechnet sind pro 160 GB/s Bandbreite höchstens etwa 10 Tok/s möglich, bevor Tricks wie Speculative Decoding noch etwas herausholen. Die reine Rechenleistung der GPU spielt bei der Textausgabe meist eine kleinere Rolle als diese Datenmenge.
Kapazität entscheidet, ob ein Modell überhaupt läuft. Bandbreite entscheidet, wie viele Token pro Sekunde es liefert. Eine Grafikkarte mit viel Bandbreite nützt dir nichts, wenn das Modell nicht in ihren VRAM passt. Großer Unified Memory nützt dir dagegen wenig, wenn dir 5 Tok/s im Alltag zu langsam sind.
Genau dieser Zielkonflikt prägt den Rest des Vergleichs. Grafikkarten wie die RTX 5090 punkten bei der Bandbreite, Unified-Memory-Systeme bei der Kapazität. Welcher Faktor für dich schwerer wiegt, hängt vor allem davon ab, wie groß deine Modelle sind und wie viel Kontext du brauchst.
Unified Memory: Apple, AMD und Nvidia im Vergleich
Alle drei Plattformen setzen auf denselben Grundgedanken: CPU und GPU greifen auf einen gemeinsamen Arbeitsspeicher zu, sodass ein Sprachmodell nicht in wenige Gigabyte Grafikspeicher passen muss. Im Alltag unterscheiden sie sich trotzdem deutlich, und zwar bei der Speicherobergrenze, beim Betriebssystem und bei der Software, mit der du deine Modelle tatsächlich startest.
Apple hat sein Line-up Ende August 2026 früher als gewohnt erneuert, ausdrücklich wegen der Nachfrage nach lokaler KI. Den Mac mini gibt es jetzt mit M6 und M5 Pro, den Mac Studio mit M5 Max und M5 Ultra. Die Obergrenze liegt beim Mac Studio bei bis zu 512 GB Unified Memory. Das gilt für die Topausstattung, nicht für den Mac Studio (M5 Max, 36 GB) aus unserem Katalog. Mehrere Macs lassen sich zusätzlich per Thunderbolt 5 RDMA koppeln und teilen sich dann die Last eines Modells, das für einen einzelnen Rechner zu groß wäre. Die Software läuft über Metal und Apples Framework MLX. Das ist ausgereift und energieeffizient, aber CUDA-Werkzeuge laufen nicht.
AMD liefert mit dem Ryzen AI Max+ PRO 495 („Gorgon Halo“) die aktuelle Generation der Halo-Chips mit 192 GB Unified Memory. Der große Vorteil ist die x86-Basis: Du kannst frei zwischen Linux und Windows wählen, Docker und gewohnte Entwicklerwerkzeuge laufen ohne Umwege. TechRadar hat auf einer solchen Maschine ein 300B-Modell ausprobiert. Die Rechnung zeigt, warum das nur ein Grenzfall ist: Schon bei etwa 4 Bit belegen 300 Milliarden Parameter rund 150 GB, für Kontext und System bleibt kaum Platz. Praktisch geht das also nur mit starker Quantisierung und bei wenigen Token pro Sekunde, eher als Machbarkeitsbeweis und nicht als flüssiges Arbeitsgerät. Der Bosgame M5 im Katalog nutzt noch den Vorgänger Ryzen AI Max+ 395 (Strix Halo) mit 128 GB und folgt demselben Prinzip.
Nvidia ist der Neuling im Lager. Der RTX Spark (N1X) ist ein Arm-Chip mit Blackwell-Grafik und Unified Memory, der Windows ohne AMD- oder Intel-CPU betreibt. Der entscheidende Punkt ist CUDA: Erstmals bekommst du Nvidias Software-Ökosystem mit gemeinsamem Speicher statt mit hart begrenztem VRAM. Notebooks mit RTX Spark sind bereits erhältlich, kompakte Desktop-Rechner stehen kurz vor dem Marktstart. Weil Windows hier auf Arm läuft, solltest du vor dem Kauf prüfen, ob deine übrigen Programme nativ oder nur per Emulation laufen.
| Kriterium | Apple (M5 Pro/Max/Ultra, M6) | AMD Ryzen AI Max+ PRO 495 | Nvidia RTX Spark (N1X) |
|---|---|---|---|
| Speicherobergrenze | bis 512 GB (Mac Studio) | 192 GB | noch keine Desktop-Angaben |
| Prozessor-Architektur | Arm (Apple Silicon) | x86 | Arm mit Blackwell-GPU |
| Betriebssystem | macOS | Linux und Windows | Windows on Arm |
| Software-Stack | Metal, MLX | offene x86-Werkzeuge unter Linux/Windows | CUDA |
| Skalierung | mehrere Macs per Thunderbolt 5 RDMA | einzelnes System | einzelnes System |
| Verfügbarkeit | Mac mini und Mac Studio im Handel | Mini-PCs im Handel | Notebooks im Handel, Mini-PCs folgen |
| Größte Stärke | größter Speicher, leise und sparsam | Systemfreiheit, viel RAM pro Euro | CUDA-Kompatibilität |
Wenn dein Modell nicht in den Speicher passt, ist alles andere zweitrangig. Wer sehr große Modelle oder langen Kontext braucht, landet deshalb bei Apple: Nur dort geht es über 192 GB hinaus, notfalls auch über mehrere Rechner. Brauchst du dagegen CUDA-Software, ohne auf eine Grafikkarte festgelegt zu sein, ist RTX Spark die interessanteste Option, sobald die kompakten Desktops erhältlich sind.
Für die Entscheidung heißt das: Apple passt zu dir, wenn du maximale Modellgröße bei geringem Stromverbrauch willst und mit macOS leben kannst. Der Mac mini (M6, 24 GB) und der Mac mini (M5 Pro, 24 GB) decken die mittlere Modellklasse ab, der Mac Studio (M5 Max, 36 GB) bietet mehr Reserve. AMD ist die Wahl, wenn du Linux brauchst oder Server-Werkzeuge ohne Umweg nutzen willst. Nvidia RTX Spark ist für dich gedacht, wenn deine Werkzeugkette auf CUDA beruht. Bis die Desktop-Modelle erscheinen, ist es aber noch eine Wette auf die Zukunft.
Dedizierte Grafikkarte: schnell, aber hart begrenzt
Die Grafikkarte ist der klassische Weg zu lokaler KI und für viele immer noch der günstigste Einstieg. heise kommt zu dem Schluss, dass schon eine Radeon RX 9070 XT für rund 920 € in einem normalen Gaming-PC für sinnvolle lokale KI reicht, auch fürs Programmieren. Zum Vergleich hat heise auch die Intel Arc Pro B70, aktuelle Mac minis und Mac Studios sowie AMDs Strix Halo herangezogen. Am oberen Ende steht die Nvidia GeForce RTX 5090 mit 32 GB GDDR7. Sie kostet im Katalog 9.995 € und damit mehr als das Zehnfache der Radeon, bietet aber nur doppelt so viel Grafikspeicher wie deren 16 GB.
Wo die Grafikkarte glänzt: Prompt-Processing und Bildgenerierung
Die Stärke liegt in der hohen Speicherbandbreite des VRAM. Dazu kommt viel Rechenleistung, und davon profitiert vor allem das Prompt-Processing, also das Einlesen deiner Eingabe, bevor das erste Token erscheint. Anders als die Textausgabe hängt dieser Schritt stärker an der GPU-Rechenleistung als an der Bandbreite. Das spürst du am deutlichsten, wenn du eine große Codedatei, ein langes PDF oder einen umfangreichen Chatverlauf übergibst. Auf einer Grafikkarte startet die Antwort dann spürbar schneller als auf den meisten Unified-Memory-Systemen.
Noch klarer ist der Vorsprung bei der Bildgenerierung. Aktuelle Modelle wie Flux.2, Krea-2, Qwen und Z-Image laufen in ComfyUI auch auf knappem VRAM, und zwar als Turbo-Versionen in FP8 oder BF16. PCGH empfiehlt dafür Python 3.13. Bildmodelle sind deutlich kleiner als große Sprachmodelle, deshalb kommt die begrenzte Speichermenge der Karte hier kaum zum Tragen. Dazu kommt das CUDA-Ökosystem: Viele Workflows, Erweiterungen und Anleitungen setzen Nvidia voraus. Deshalb ist die RTX 5090 für Bild-KI die naheliegende Wahl, obwohl sie so teuer ist.
Die harte Grenze: Was nicht in den VRAM passt, wird langsam
Ist ein Sprachmodell samt Kontext größer als der Grafikspeicher, lagert die Software einzelne Schichten in den Arbeitsspeicher (RAM) aus. Der ist über PCIe angebunden und deutlich langsamer. Das Tempo sinkt dann nicht ein wenig, es bricht ein. Die Grafikkarte wartet bei jedem Token auf Daten aus dem RAM.
Für dich als Käufer heißt das: Die VRAM-Größe ist keine weiche Empfehlung, sondern eine Obergrenze. Für die meisten Aufgaben ist es besser, ein kleineres Modell oder eine stärkere Quantisierung vollständig in den VRAM zu laden, als ein größeres Modell teilweise auszulagern.
| Szenario | 16 GB VRAM (RX 9070 XT) | 32 GB VRAM (RTX 5090) |
|---|---|---|
| Bildmodelle als Turbo-Version in FP8/BF16 | läuft | läuft mit mehr Spielraum |
| Sprachmodell um 27B in Q4 | sehr knapp, wenig Platz für Kontext | passt mit Reserve für Kontext |
| Sprachmodell deutlich über 32 GB | nur ausgelagert, stark gebremst | nur ausgelagert, stark gebremst |
| Langer Kontext (Hunderttausende Token) | nicht realistisch | nur mit kleinem Modell |
Ein Mac Studio (M5 Max, 36 GB) bietet für 2.599 € auf dem Papier schon mehr Speicher als die RTX 5090, nach Abzug der Systemreserve aber nur ungefähr gleich viel. Der Bosgame M5 mit 128 GB fasst das Vierfache. Beide sind langsamer, solange das Modell in die 32 GB der Nvidia-Karte passt. Oberhalb dieser Grenze gewinnen sie dafür deutlich.
Kompakt geht auch mit Grafikkarte
Ein häufiges Argument für Mini-PCs ist die Größe. Das gilt aber nur noch eingeschränkt: Die meisten aktuellen Mini-ITX-Gehäuse fassen Grafikkarten mit voller Länge und 2–3 Slots. Ein kompakter GPU-PC mit RX 9070 XT oder RTX 5090 ist also machbar. Rechne aber mit einem kräftigen Netzteil und einer höheren Leistungsaufnahme unter Last, und plane die Kühlung entsprechend ein. Wenn du einen leisen, sparsamen Mini-PC auf dem Schreibtisch willst, ist ein Mac mini (M5 Pro, 24 GB) die ruhigere Lösung. Er ist bei Bild-KI allerdings langsamer.
Vorteile
- Hohe Bandbreite und viel Rechenleistung sorgen für schnelle Textausgabe und schnelles Prompt-Processing, solange das Modell in den VRAM passt
- Bildmodelle wie Flux.2 oder Z-Image laufen in ComfyUI als FP8/BF16-Turbo-Version auch auf knappem VRAM
- Günstiger Einstieg: Laut heise reicht eine RX 9070 XT für rund 920 € schon fürs Programmieren
- CUDA-Software und ComfyUI-Workflows laufen auf der RTX 5090 ohne Umwege
- Passt dank Mini-ITX-Gehäusen mit Platz für 2–3-Slot-Karten auch in einen kompakten PC
Nachteile
- Harte VRAM-Grenze: Sobald Schichten in den RAM wandern, bricht das Tempo ein
- Selbst die RTX 5090 bietet nur 32 GB, zu wenig für große Modelle mit langem Kontext
- Sehr hoher Preis pro Gigabyte Grafikspeicher im High-End-Segment
- Höhere Leistungsaufnahme und Lautstärke als bei Unified-Memory-Mini-PCs
MoE-Modelle und Software: wo sich die Grenzen verschieben
Die Faustregel „Das Modell muss komplett in den schnellen Speicher passen" gilt vor allem für dichte Modelle. Bei ihnen rechnet jedes Token mit allen Gewichten. Mixture-of-Experts-Modelle (MoE) arbeiten anders. Ein Router wählt pro Token nur wenige spezialisierte Teilnetze aus, die sogenannten Experten. Der Rest des Modells bleibt in diesem Schritt ungenutzt. Dadurch ändert sich das Verhältnis zwischen Speicherbedarf und Tempo.
Gemma 4 26B A4B: groß im Speicher, klein in der Rechnung
Ein gutes aktuelles Beispiel ist Googles Gemma 4 26B A4B. Das Modell hat rund 26 Milliarden Parameter, rechnet pro Token aber nur mit etwa 4B aktiven Parametern. Die Generierung liegt damit beim Tempo eher in der Nähe eines kleinen Modells. Beim Wissen und bei der Antwortqualität spielt es dagegen in einer höheren Klasse.
Der praktische Vorteil zeigt sich, wenn der Grafikspeicher (VRAM) knapp wird. Ruhende Experten lassen sich in den System-RAM auslagern, während die häufig genutzten Teile auf der Grafikkarte bleiben. Das Tempo bricht dabei deutlich weniger ein als bei einem dichten Modell. Dort muss bei jedem Token alles über den langsamen PCIe-Bus. Für eine Grafikkarte mit 8 bis 16 GB VRAM verschiebt MoE also die Grenze dessen, was sinnvoll nutzbar ist. Für Unified-Memory-Rechner wie den Bosgame M5 mit 128 GB oder den Mac Studio (M5 Max, 36 GB) heißt es: Die geringe Rechenlast pro Token gleicht die niedrigere Bandbreite gegenüber einer Nvidia GeForce RTX 5090 teilweise aus.
Die ganze Gemma-4-Familie im Überblick:
| Modell | Typ | Gedacht für | Kontext |
|---|---|---|---|
| E2B | dicht, multimodal inkl. Audio | Smartphone, Notebook | 128K |
| E4B | dicht, multimodal inkl. Audio | Notebook, Mini-PC | 128K |
| 12B | dicht, multimodal inkl. Audio | Grafikkarte der Mittelklasse | 256K |
| 26B A4B | MoE, ~4B aktiv | Grafikkarte, Unified Memory | 256K |
| 31B | dicht | Workstation, große Grafikkarte | 256K |
Gemma 4 steht unter Apache 2.0. Du darfst es also auch kommerziell ohne Sonderlizenz einsetzen. Die mittleren Modelle bieten 256K Kontext. Das reicht für ganze Codebasen oder lange Vertragsstapel, sofern dein Arbeitsspeicher den KV-Cache trägt. Am schnellsten startest du per docker model pull gemma4, denn seit April 2026 liegt das Modell auf Docker Hub.
Software: CUDA vorn, der Rest holt auf
Hardware nützt wenig, wenn das Backend hakt. Ein aktueller Datenpunkt stammt von igorslab: Auf dem ASUS ROG GR70 mit RTX 5070 Laptop und nur 8 GiB VRAM lief Gemma 4 E4B in der Quantisierung Q4KXL unter llama.cpp mit CUDA schneller als mit Vulkan. Das passt ins Gesamtbild. CUDA hat die reifste Toolchain. Neue Modelle, Quantisierungsformate und Tricks wie speculative decoding landen hier meist zuerst, und ComfyUI-Workflows setzen es oft stillschweigend voraus.
| Backend | Plattform | Reifegrad | Aufwand für dich |
|---|---|---|---|
| CUDA | Nvidia-Grafikkarten | am weitesten | gering, fast alles läuft sofort |
| Metal / MLX | Apple Silicon | gut gepflegt | gering, LM Studio und llama.cpp unterstützen beides |
| ROCm | AMD (Radeon, Ryzen AI Max) | funktioniert | mittel, Treiber und Versionen müssen passen |
| Vulkan | herstellerübergreifend | funktioniert | gering bis mittel, oft etwas langsamer |
Auf dem Mac sind Metal und MLX gut gepflegt. Ein Mac mini (M6, 24 GB) oder Mac mini (M5 Pro, 24 GB) läuft mit gängigen Tools ohne Bastelei. Bei AMD-Systemen wie dem Bosgame M5 oder dem Minisforum UM890 Pro funktionieren ROCm und Vulkan, brauchen aber mehr Handarbeit. Du wählst Backend-Builds selbst, prüfst Kernel- und Treiberversionen und musst bei neuen Modellen gelegentlich ein paar Wochen auf Unterstützung warten. Wer lieber einrichtet als nutzt, kommt damit gut klar. Wer einfach arbeiten will, ist mit Nvidia oder Apple entspannter unterwegs.
Profi-Tipp
Ist dein VRAM zu klein, greif zuerst zur MoE-Variante statt zum nächstkleineren dichten Modell. Gemma 4 26B A4B mit ausgelagerten Experten bringt auf einer 8- bis 16-GB-Grafikkarte das Wissen eines größeren Modells mit und rechnet pro Token trotzdem nur mit etwa 4B aktiven Parametern. Probiere in llama.cpp außerdem beide Backends, also CUDA bzw. ROCm gegen Vulkan. Der Unterschied hängt von Modell und Treiber ab und lässt sich in wenigen Minuten selbst messen.
MoE verschiebt damit die Abwägung aus dem vorigen Abschnitt: Speicher bleibt die erste Hürde, doch sie ist weicher geworden. Die Software entscheidet dann, wie viel Tempo du aus der Hardware herausholst. Hier hat Nvidia weiterhin den Vorsprung, Apple den geringsten Aufwand und AMD das beste Verhältnis aus viel Arbeitsspeicher und etwas Bastelbereitschaft.
Was ein Gigabyte KI-Speicher kostet
Bei lokaler KI zählt zuerst, wie viel Modell in den Speicher passt. Deshalb ist der Preis pro Gigabyte nutzbarem KI-Speicher die aussagekräftigste Kennzahl, mehr als CPU-Kerne oder TOPS-Angaben. Teilt man die Katalogpreise durch den Speicher der jeweils verkauften Konfiguration, liegen die Systeme um mehr als den Faktor zehn auseinander:
- Bosgame M5 (128 GB Unified Memory, 3.699 €): rund 29 € pro GB
- Apple Mac mini (M6, 24 GB) (1.299 €): rund 54 € pro GB
- Apple Mac mini (M5 Pro, 24 GB) (1.699 €): rund 71 € pro GB
- Apple Mac Studio (M5 Max, 36 GB) (2.599 €): rund 72 € pro GB
- Nvidia GeForce RTX 5090 (32 GB GDDR7, 9.995 €): rund 312 € pro GB VRAM
Die Rechnung schmeichelt dem Unified Memory allerdings etwas. Beim gemeinsamen Speicher musst du einen Teil für Betriebssystem, Programme und CPU abziehen, denn er dient nicht nur dem Modell. Nehmen wir für einen 24-GB-Mac mini etwa 8 GB Systemreserve an, bleiben rund 16 GB für Modell und Kontext. Damit steigt der effektive Preis beim M6 auf etwa 81 € pro GB. Beim Bosgame M5 fällt dieselbe Reserve kaum ins Gewicht: Mit grob 112 GB nutzbarem Speicher landest du bei rund 33 € pro GB. Bei der RTX 5090 gehören die 32 GB VRAM vollständig dem Modell. Dafür kommt aber noch ein kompletter PC mit Netzteil, Gehäuse und Arbeitsspeicher hinzu, und der Abstand wächst weiter.
So rechnest du richtig
Teile den Preis nicht durch den angegebenen Gesamtspeicher, sondern durch den Speicher, der nach Abzug von System und Kontextpuffer übrig bleibt. Ein 16-GB-Modell wie Qwen 3.8-27B in Q4 braucht für langen Kontext spürbar mehr Platz als nur die Gewichte. Ein System mit 24 GB ist dann schnell knapper bemessen, als der Preis pro GB vermuten lässt.
Knappe Speicherchips, teure Neuheiten
Die Preise spiegeln einen angespannten Markt. Der Mac mini startet inzwischen ab 1.049 €, also deutlich über früheren Einstiegspreisen. Wegen der Knappheit bei Speicherchips waren viele Konfigurationen monatelang kaum lieferbar, vor allem die mit viel Arbeitsspeicher. Am oberen Ende ist es ähnlich: Mini-PCs mit dem neuen Gorgon Halo (Ryzen AI Max+ PRO 495) und 192 GB Unified Memory beginnen bei etwa 6.799 $. Das sind rund 35 $ pro GB. Der Preis pro GB liegt damit etwas über dem des Bosgame M5, dafür kaufst du die aktuelle Generation und Platz für deutlich größere Modelle.
Die Preisblase bei Grafikkarten
Wie verzerrt der Grafikkartenmarkt ist, zeigt ein Blick auf die Vorgängergeneration. Eine vier Jahre alte RTX 4090 kostet gebraucht rund 4.000 €, neu werden bis zu 5.000 € verlangt. Für 24 GB VRAM sind das gebraucht etwa 167 € pro GB. Das ist weniger als bei der RTX 5090, aber immer noch mehr als das Doppelte des teuersten Macs im Katalog, und dazu kommt das Risiko einer Karte ohne Garantie. Der hohe Preis ergibt nur Sinn, wenn du die Stärken der Grafikkarte wirklich nutzt: CUDA-Software, Bildgenerierung in ComfyUI und hohes Tempo bei Modellen, die komplett in den VRAM passen. Wer vor allem große Sprachmodelle laden will, bezahlt bei der GPU einen Aufpreis für Geschwindigkeit, die an der Speichergrenze verpufft.
Ausblick: Warten oder jetzt kaufen?
Drei Entwicklungen solltest du im Blick behalten, bevor du mehrere Tausend Euro ausgibst:
- Qwen 4 steht kurz bevor. Ob die neue Generation mit ähnlich kompakten Gewichten wie Qwen 3.8-27B auskommt oder mehr Speicher verlangt, entscheidet darüber, ob 24 GB weiterhin genügen.
- RTX-Spark-Desktops kommen. Kompakte Rechner mit Nvidias Arm-Blackwell-Chip verbinden Unified Memory mit CUDA. Das könnte Druck auf die Preise pro GB machen und den Grafikkarten-Aufpreis für CUDA infrage stellen.
- Lokale Modelle liegen etwa ein halbes Jahr hinter der Cloud-Spitze wie Claude Opus 5.5. Mit mehr Speicher bleibst du näher an diesem Rückstand, weil du größere und neuere Modelle laden kannst.
Unterm Strich bekommst du heute beim Unified Memory klar mehr Modellkapazität pro Euro. Der Bosgame M5 ist der günstigste Weg zu großen Modellen, die Macs liegen preislich in der Mitte. Die RTX 5090 rechnet sich nur dort, wo ihre Geschwindigkeit und das CUDA-Ökosystem den mehr als vierfachen Preis pro Gigabyte rechtfertigen.
Welche Architektur zu dir passt
Die Faustregel aus den vorigen Abschnitten lässt sich in vier Kaufempfehlungen übersetzen. Entscheidend ist, welches Modell du dauerhaft im Arbeitsspeicher halten willst, und erst danach, wie viele Token pro Sekunde du brauchst. Jedes Profil bekommt genau ein Gerät aus unserem Katalog. Bei den Datenschutz-Profis sind es zwei, weil Budget und Kontextbedarf dort weit auseinandergehen.
| Profil | Typisches Modell | Speicherbedarf | Passende Architektur |
|---|---|---|---|
| Coder | Qwen 3.8-27B in Q4 | ca. 16 GB Gewichte plus Kontext | Unified Memory, 24 GB |
| Bild-KI-Hobbyist | Flux.2, Krea-2, Z-Image in ComfyUI | je nach Präzision FP8 oder BF16 | Grafikkarte mit CUDA |
| Datenschutz-Profi | 27B-Klasse mit sehr langem Kontext | 36 bis 128 GB | Unified Memory, viel RAM |
| Tüftler | sehr große Modelle, stark quantisiert | 128 GB und mehr | Unified Memory unter Linux |
Coder: Apple Mac mini (M5 Pro, 24 GB, 512 GB). In Q4 belegt Qwen 3.8-27B rund 16 GB. Damit bleiben auf 24 GB etwa 8 GB für macOS, Editor und den KV-Cache, genug für ein normales Repository im Kontext. Für Agenten, die ganze Codebasen einlesen, wird es eng. Den Ausschlag geben die 16-Core-GPU und der Mini-PC-Formfaktor: Die Kiste läuft leise und mit geringer Leistungsaufnahme den ganzen Tag als lokaler Code-Assistent. Das kann eine 5090 im großen Tower so nicht. Der Mac mini (M6, 24 GB) hat gleich viel Arbeitsspeicher und kostet 400 € weniger. Für flüssiges Coding ist die größere GPU des M5 Pro aber die sinnvollere Investition.
Bild-KI-Hobbyist: Nvidia GeForce RTX 5090. Die 32 GB GDDR7 fassen aktuelle Bildmodelle in ComfyUI ohne Turbo-Kompromisse. FP8- und BF16-Workflows laufen auf CUDA am reibungslosesten, weil fast jede Custom Node und jede Anleitung zuerst für Nvidia geschrieben wird. Das echte Gegenargument ist der Preis: 9.995 € für die Karte allein, dazu kommen Netzteil, Gehäuse und Plattform. Wenn du nur gelegentlich Bilder generierst, zahlst du hier die oben beschriebene Preisblase bei Grafikkarten voll mit.
Datenschutz-Profi mit Dokumenten und langem Kontext: Apple Mac Studio (M5 Max, 36 GB) oder Bosgame M5 (128 GB). Verträge, Akten und Patientendaten sollen das Haus nicht verlassen, aber das Modell soll Hunderte Seiten gleichzeitig im Blick haben. Der Mac Studio lässt dir mit 36 GB nach den rund 16 GB eines 27B-Modells in Q4 und etwa 8 GB für macOS noch gut 12 GB für den KV-Cache. Das reicht für lange Einzeldokumente, er bleibt leise und ist mit 2.599 € erschwinglich. Für richtig große Kontextfenster ist der Bosgame M5 die stärkere Wahl. Die 512K-Token von Qwen 3.8-27B wurden auf einem Rechner mit 128 GB Unified Memory erreicht, und genau diese Größe bringt der Bosgame mit.
Tüftler mit sehr großen Modellen: Bosgame M5 (Ryzen AI Max+ 395, 128 GB, 2 TB). Mit rund 29 € pro GB ist er der günstigste Weg zu 128 GB Unified Memory. Unter Linux kannst du die Speicheraufteilung zwischen CPU und GPU frei anpassen und mit llama.cpp oder Vulkan experimentieren. Beachte aber: Der Chip ist die Strix-Halo-Vorgängergeneration. Wer mehr als 128 GB braucht, schaut auf Systeme mit Gorgon Halo und 192 GB oder vernetzt mehrere Mac Studios per Thunderbolt 5 RDMA. Beide Wege kosten ein Vielfaches und lohnen sich nur, wenn du wirklich Modelle jenseits der 100B-Klasse betreiben willst.
Gut für
- Entwickler, die Qwen 3.8-27B als Code-Assistenten dauerhaft lokal laufen lassen wollen: Mac mini mit M5 Pro
- Bild-KI-Fans, die ComfyUI ohne Kompromisse bei Präzision und Kompatibilität nutzen wollen und das Budget dafür haben: RTX 5090
- Kanzleien, Praxen und Selbstständige, die lange Dokumente vollständig offline auswerten müssen: Mac Studio oder Bosgame M5
- Linux-Bastler, die mit 128 GB möglichst viel Modell pro Euro wollen: Bosgame M5
Nicht für
- Alle, die nur ab und zu ein Bild generieren: Für 9.995 € rechnet sich die RTX 5090 dann nicht
- Nutzer, die ganze Codebasen mit sehr langem Kontext verarbeiten wollen: Dafür sind 24 GB im Mac mini zu knapp
- Käufer, die die neueste AMD-Generation erwarten: Der Bosgame M5 nutzt noch Strix Halo statt Gorgon Halo
Kurz gesagt
Brauchst du viel Speicher für große Modelle und langen Kontext, greif zu Unified Memory. Brauchst du Tempo und CUDA für Bild-KI, nimm die Grafikkarte. Bei Sprachmodellen gilt: erst die Speichergröße festlegen, dann nach der Geschwindigkeit auswählen.
Häufige Fragen zu Unified Memory und Grafikkarte
Die folgenden Antworten klären die Fragen, an denen die meisten Kaufentscheidungen hängen: wie knapp 24 GB wirklich sind, ob sich eine gebrauchte RTX 4090 noch lohnt, was 192 GB bringen und ob sich Warten auszahlt.
Häufig gestellte Fragen
Reichen 24 GB Unified Memory für Qwen 3.8-27B?
Ja, in Q4 – aber mit wenig Puffer. Die Gewichte von Qwen 3.8-27B belegen in der Unsloth-Quantisierung UD-Q4KXL rund 16 GB. Bei einem Mac mini mit 24 GB teilen sich macOS, Browser, Editor und das Modell denselben Speicher. Für den KV-Cache, der mit jedem Token Kontext wächst, bleiben dann nur wenige Gigabyte übrig.
Für Coding-Sessions mit überschaubarem Kontext genügt das. Den nativen Kontext von 262.144 Token oder gar die per YaRN erweiterten 512K kannst du auf 24 GB aber nicht ausnutzen, dafür war ein Rechner mit 128 GB nötig. Zwischen den beiden 24-GB-Modellen spricht für den Apple Mac mini (M5 Pro, 24 GB) die stärkere 16-Core-GPU. Der Apple Mac mini (M6, 24 GB) kostet mit 1.299 € weniger, stößt aber an dieselbe Speichergrenze. Wenn du regelmäßig lange Dokumente oder ganze Codebasen in den Kontext lädst, bieten dir die 36 GB im Apple Mac Studio (M5 Max) spürbar mehr Luft.
Lohnt eine gebrauchte RTX 4090 für rund 4.000 €?
Für die meisten kaum. Die Karte ist vier Jahre alt und kostete zum Start 1.769 €. Heute zahlst du auf Kleinanzeigen etwa 4.000 € und neu bis zu 5.000 €. Dafür bekommst du 24 GB VRAM, nominell so viel wie der Mac mini (M6, 24 GB) für 1.299 € als kompletten Rechner.
Laut heise schafft eine Radeon RX 9070 XT für rund 920 € in einem normalen Gaming-PC schon brauchbare lokale KI-Arbeit, Coding eingeschlossen. Die rund 3.000 € Aufpreis für die 4090 zahlen sich nur aus, wenn du auf CUDA-Workflows angewiesen bist, die auf AMD nicht oder nur holprig laufen. Und selbst dann lohnt der Blick auf die Nvidia GeForce RTX 5090. Sie ist deutlich teurer, bietet aber 32 GB GDDR7 und ist die aktuelle Generation.
Ist ein 300B-Modell auf 192 GB sinnvoll?
Nur stark quantisiert und nur, wenn du Geduld hast. 300 Milliarden Parameter brauchen in 4 Bit rein rechnerisch schon rund 150 GB, ohne KV-Cache und Betriebssystem. Auf einem Rechner mit Ryzen AI Max+ PRO 495 (Gorgon Halo) und 192 GB bleibt damit kaum Platz für Kontext. Praktikabel wird es erst mit noch aggressiverer Quantisierung, die sichtbar Qualität kostet.
Dazu kommt das Tempo: Bei jedem Token muss ein großer Teil der Gewichte durch den Speicher, deshalb begrenzt die Speicherbandbreite die Token pro Sekunde. Bei einem Mixture-of-Experts-Modell mit wenigen aktiven Parametern sieht es besser aus. Für den Alltag fährst du mit einem guten 27B- bis 31B-Modell meist besser, denn es antwortet zügig und lässt Raum für langen Kontext. Für ein 300B-Modell reichen die 128 GB des Bosgame M5 nicht. Für stark quantisierte Modelle um die 100B-Klasse genügen sie aber.
Soll ich auf Qwen 4 oder RTX-Spark-Desktops warten?
Auf Qwen 4 lohnt sich das Warten nicht. Neue Modelle laufen auf derselben Hardware. Ein Nachfolger in ähnlicher Größe passt also in dieselbe Speicherklasse wie Qwen 3.8-27B. Und auch ohne Qwen 4 bekommst du mit Qwen 3.8-27B schon heute ein lokales Modell, das nur etwa ein halbes Jahr hinter der Cloud-Spitze liegt.
Auf RTX Spark zu warten lohnt sich nur, wenn du CUDA auf Unified Memory willst. Nvidias Arm-Blackwell-Chip N1X verbindet gemeinsamen Speicher mit dem CUDA-Ökosystem unter Windows. Notebooks gibt es bereits, kompakte Desktops stehen kurz vor dem Start. Preise und Speicherausbau dieser Desktops sind aber noch offen. Wenn du hauptsächlich Text-KI nutzt und mit macOS, Linux oder Vulkan gut zurechtkommst, kaufst du besser jetzt, denn die Preise für KI-fähige Hardware sind 2026 eher gestiegen als gefallen.