Apple Mac Studio (M5 Max, 36 GB) im Review: stark für Kreative, knapp für lokale KI
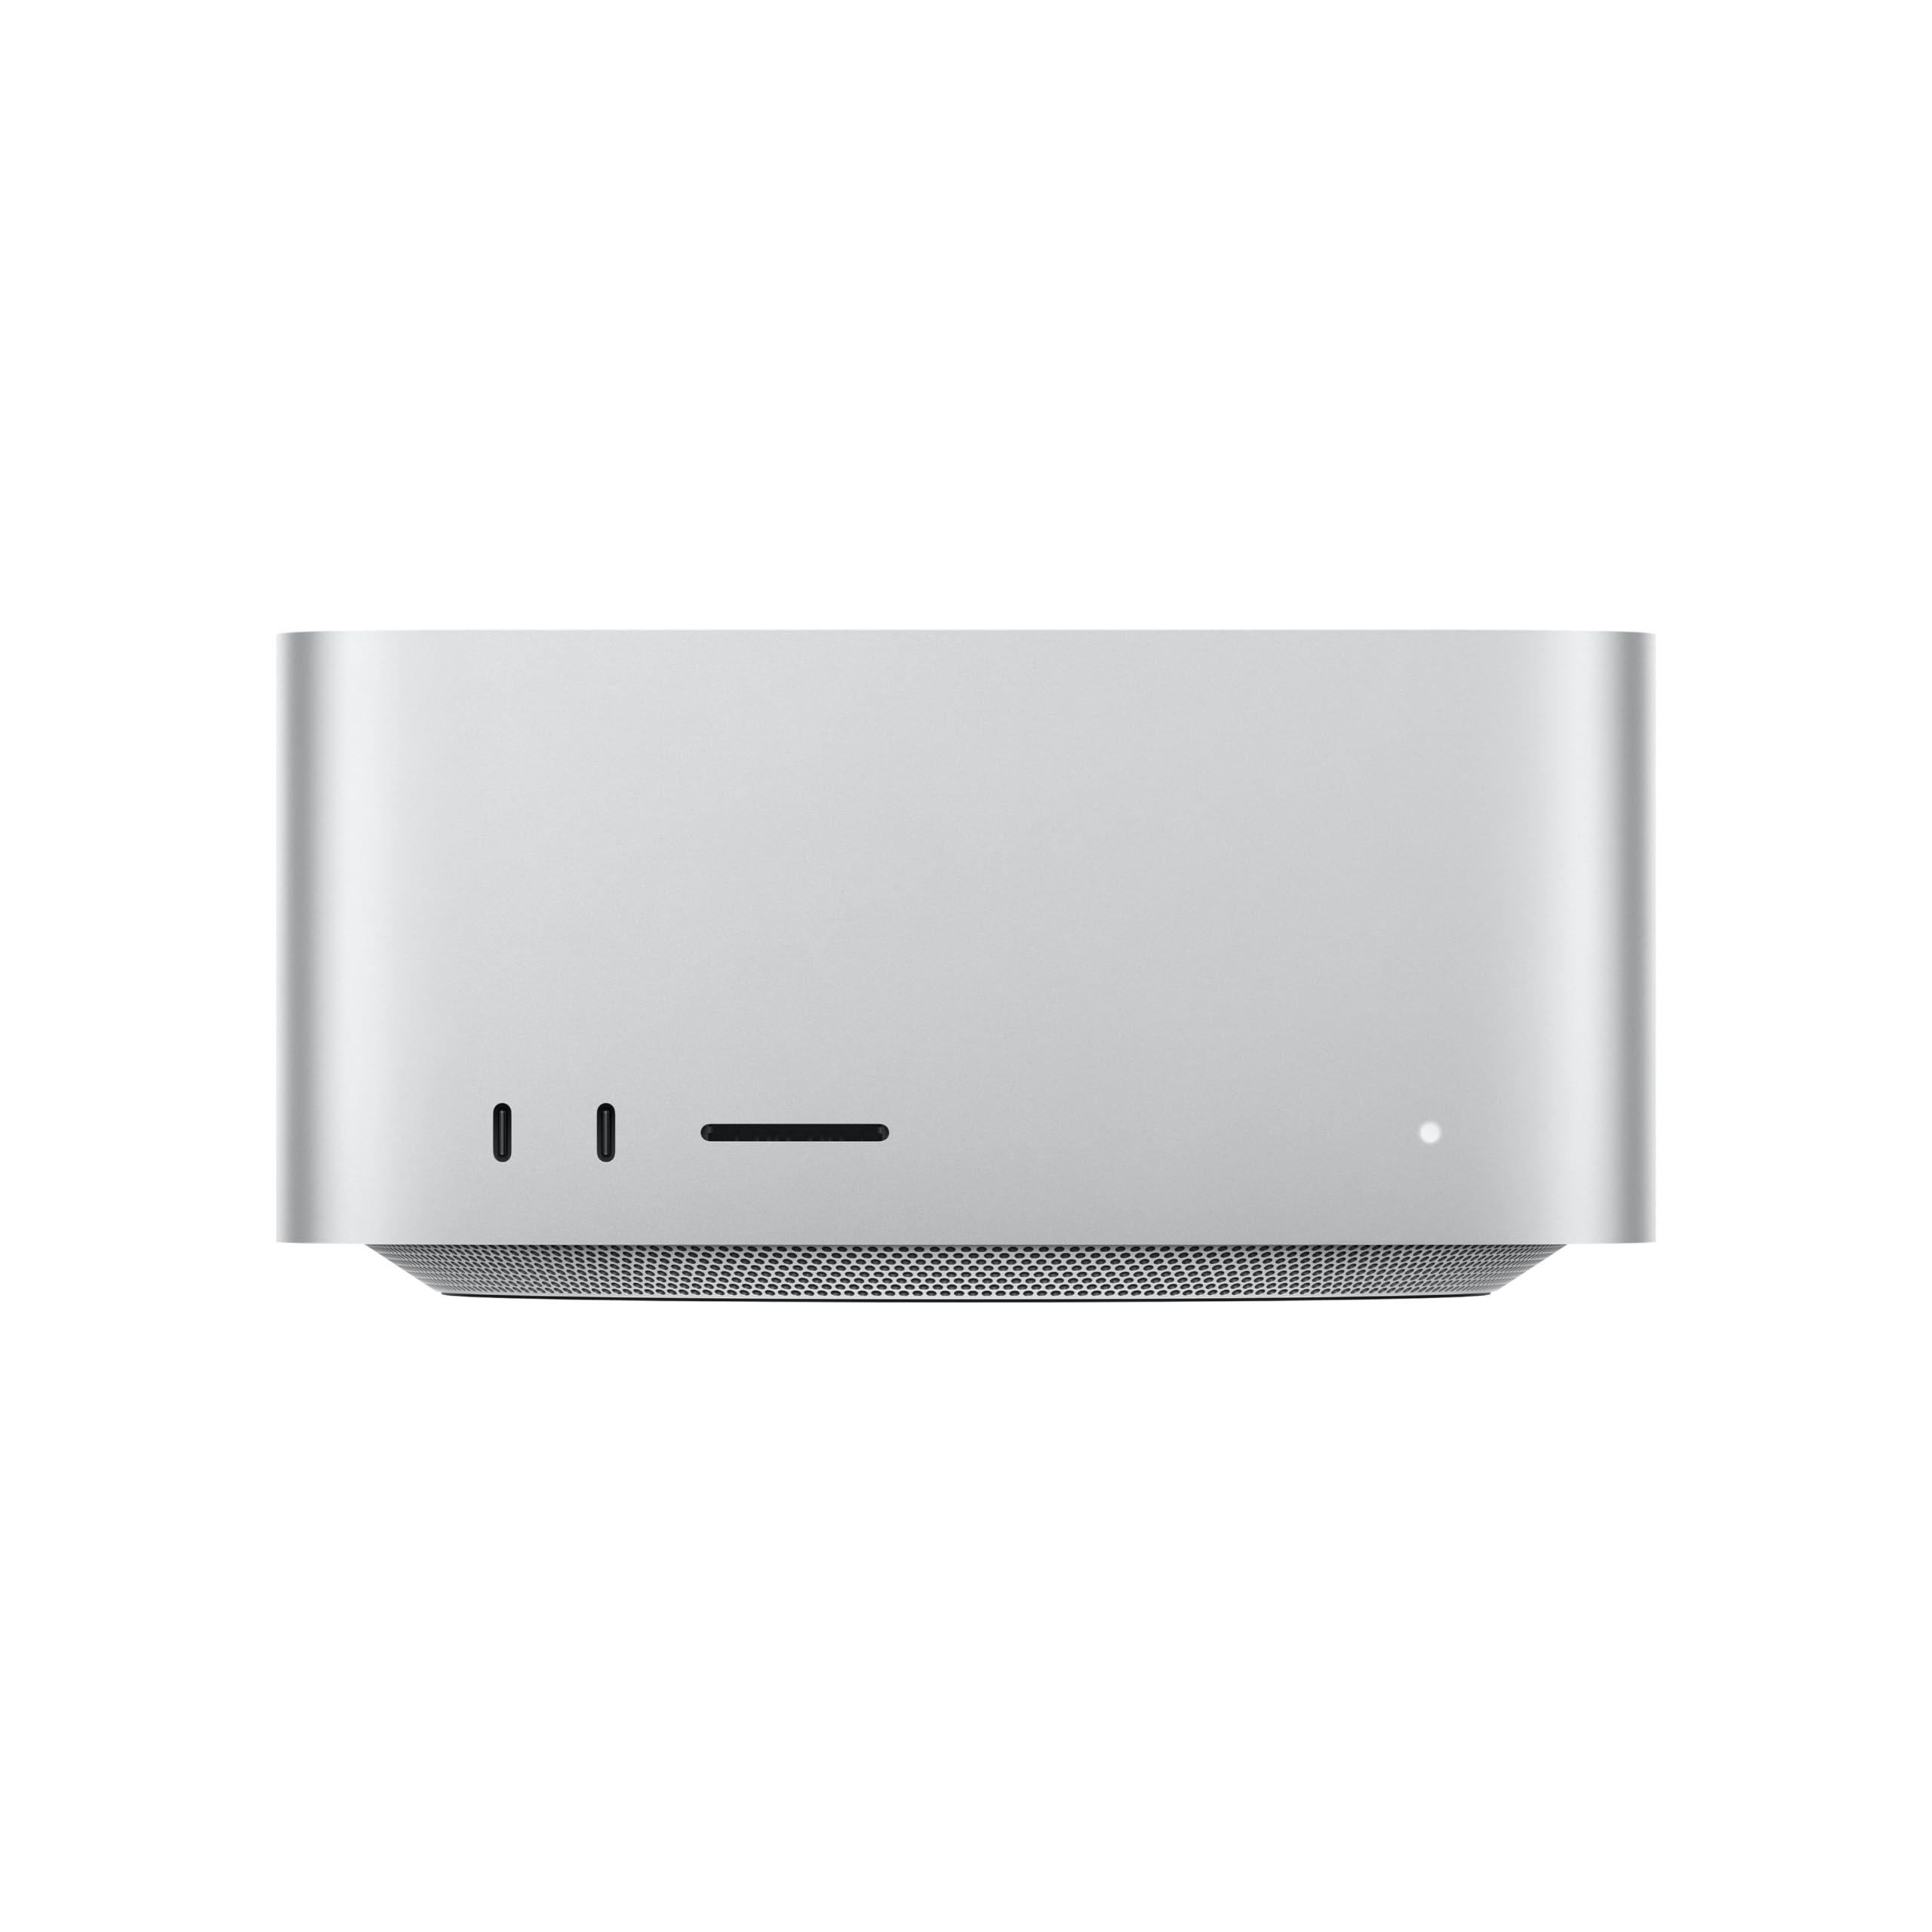

36 GB Unified Memory für 27B-Modelle wie Qwen 3.8 – leise auf dem Schreibtisch
- Configuration
- M5 Max, 18‑Core CPU und 32‑Core GPU, 36GB RAM, 512 GB SSD
- Prozessor
- Apple M5 Max 18-Core
- Arbeitsspeicher (RAM/VRAM)
- 36 GB
- Speicherbandbreite
- 460 GB/s
- 36 GB: Qwen 3.8-27B passt komplett
- Neural Accelerator je GPU-Kern
- 36 GB verlötet, später nicht aufrüstbar
Qwen 3.8-27B braucht als Q4-Quantisierung rund 16 GB und läuft damit bequem im 36 GB großen gemeinsamen Speicher dieses Mac Studio. Bei 70B-Modellen oder sehr langen Kontexten ist hier aber Schluss, und nachrüsten kannst du später nichts. Für 2.599,00 € bekommst du also eine sehr starke Kreativ-Workstation, deren KI-Spielraum du vor dem Kauf genau kennen solltest.
Vorteile
- 36 GB: Qwen 3.8-27B passt komplett
- Neural Accelerator je GPU-Kern
- 4× Thunderbolt 5 für KI-Cluster
- Leise unter Last, nur 19,7 cm
Nachteile
- 36 GB verlötet, später nicht aufrüstbar
- 512 GB SSD füllt sich mit Modellen
- Mehr RAM nur gegen hohen Aufpreis
Design und Verarbeitung
Der Mac Studio ist ein quadratischer Aluminiumblock mit 19,7 cm Seitenlänge. Das klingt unspektakulär, ist im Alltag aber ein echtes Argument: Das Gehäuse passt unter die meisten Monitore und verschwindet dort fast. Das Modell MHL64ZD/A gibt es in Silber. Gehäuse, Anschlüsse und Kühlung bilden eine geschlossene Einheit. Ein Werkzeugfach, Laufwerksschächte oder Steckplätze suchst du vergeblich.
Platzbedarf: kleiner als jeder vergleichbare KI-PC
Der Vergleich mit einem Windows-Rechner zeigt, wie kompakt das Gerät ist. Wer eine RTX 5090 nutzen will, braucht auch im Mini-ITX-Format ein Gehäuse, das eine lange Grafikkarte mit zwei bis drei Slots aufnimmt, dazu ein starkes Netzteil und Platz für die Luftzirkulation. Ein solches Gehäuse steht meist neben dem Monitor oder unter dem Tisch. Der Mac Studio braucht weniger Stellfläche als ein solcher Mini-ITX-Aufbau. Er bleibt in Reichweite auf dem Schreibtisch, und SD-Karten oder Kopfhörer steckst du ein, ohne dich zu bücken.
Das spielt eine Rolle, wenn du in einer Wohnung, einem kleinen Büro oder einem geteilten Arbeitsraum arbeitest. Ein 2.599-€-Rechner, der Video, 3D und Sprachmodelle bis etwa 27B übernimmt, aber kaum größer ist als eine externe Festplattenstation, verändert die Planung des Arbeitsplatzes stärker als jede Benchmark-Zahl.
Wärmemanagement: leise unter Dauerlast – laut Apple
Apple verspricht ein Kühlsystem, das den Rechner auch bei anspruchsvollen Aufgaben schnell und dabei leise hält. Eigene Messwerte haben wir nicht, die Aussage stammt vom Hersteller. Für lokale KI ist dieser Punkt trotzdem wichtiger als für klassische Kreativarbeit. Ein Video-Export dauert ein paar Minuten. Ein Sprachmodell, das Code generiert, lange Dokumente zusammenfasst oder als Agent im Hintergrund läuft, belastet den Chip dagegen über Stunden hinweg.
Steht der Rechner einen halben Meter neben dir, entscheidet die Lüftercharakteristik darüber, ob du konzentriert arbeiten kannst. Eine High-End-Grafikkarte wie die RTX 5090 ist unter Volllast mit Luftkühlung kaum flüsterleise zu bekommen. Ein SoC, der CPU, GPU und Neural Accelerator auf einem Chip vereint, hat hier einen grundsätzlichen Vorteil, weil weniger Abwärme anfällt.
Fest verbaut: Die Konfiguration beim Kauf ist endgültig
Die wichtigste Konsequenz der kompakten Bauweise: Arbeitsspeicher und SSD sind fest verlötet. Die 36 GB Unified Memory und die 512-GB-SSD lassen sich später weder tauschen noch erweitern. Beim Gaming-PC ersetzt du nach zwei Jahren die Grafikkarte oder steckst RAM-Riegel nach. Beim Mac Studio legst du dich an der Kasse fest.
Bei Apple ist die Konfiguration beim Kauf endgültig. Für lokale KI bestimmt der Arbeitsspeicher, wie groß ein Sprachmodell sein darf. Wenn du heute schon ahnst, dass 27B-Modelle in Q4 nicht reichen werden, hilft dir später kein Upgrade. Dann musst du gleich eine größere Variante wählen. Laut Hersteller sind beim M5 Max bis zu 128 GB möglich, zu einem deutlich höheren Preis.
| Merkmal | Mac Studio M5 Max (MHL64ZD/A) | Folge für dich |
|---|---|---|
| Seitenlänge | 19,7 cm | passt unter die meisten Monitore |
| Farbe | Silber | Farbe des Modells MHL64ZD/A |
| Arbeitsspeicher | 36 GB Unified Memory, fest verlötet | Obergrenze für Modellgröße und Kontext bleibt dauerhaft |
| SSD | 512 GB, fest verbaut | Erweiterung nur extern über Thunderbolt |
| Kühlung | integriertes Wärmemanagement, laut Apple leise unter Last | geeignet für Rechner direkt am Arbeitsplatz |
Die Verarbeitung ist damit ein klarer Tausch: Du bekommst ein kleines, ruhiges und aufgeräumtes Gerät und gibst dafür jede Möglichkeit zur Aufrüstung im Inneren auf. Für Kreative mit einem klar umrissenen Arbeitspensum ist das ein fairer Handel. Wer seine KI-Pläne noch nicht abschätzen kann, sollte den fest verbauten Arbeitsspeicher als den eigentlichen Haken dieses Designs sehen.
Leistung bei Kreativarbeit und lokaler KI
Im Mac Studio steckt der M5 Max mit 18 CPU-Kernen und 32 GPU-Kernen. Die GPU bietet Raytracing der dritten Generation, und laut Apple sitzt in jedem GPU-Kern ein eigener Neural Accelerator. Das ist der eigentliche Fortschritt dieser Generation. Matrixrechnungen für KI laufen damit direkt in der Grafikeinheit, statt nur auf der vergleichsweise kleinen NPU. Davon profitieren drei Bereiche: KI-Funktionen in Schnittprogrammen wie Maskierung oder Rauschunterdrückung, das Rendern von 3D-Szenen und die Inferenz von Sprachmodellen.
Bei Videoschnitt und 3D spielt die Konfiguration mit 36 GB ihre Stärken voll aus. Mehrspurige Timelines, Farbkorrektur und Raytracing-Vorschauen brauchen deutlich weniger Arbeitsspeicher als ein großes Sprachmodell. Für Fotografen und Editoren ist der Chip deshalb die wichtigere Größe, und hier bekommst du die volle Max-Klasse.
Spanne der hier verglichenen Produkte
Speicherbandbreite: der Taktgeber für Sprachmodelle
Apple nennt bis zu 614 GB/s Speicherbandbreite. Bei Sprachmodellen zählt dieser Wert mehr als die reine Rechenleistung. Für jedes erzeugte Token muss das Modell seine Gewichte komplett aus dem Arbeitsspeicher lesen. Daraus ergibt sich eine grobe Faustregel: Bandbreite geteilt durch Modellgröße ergibt die theoretische Obergrenze an Token pro Sekunde. Bei einem 16-GB-Modell liegt sie rechnerisch bei knapp 38 Tok/s. In der Praxis landest du darunter, weil Kontext, Software und Overhead mitspielen. Techniken wie speculative decoding können die Lücke aber teilweise schließen.
Apple formuliert die 614 GB/s als Höchstwert der Baureihe. Bei früheren Max-Chips hatte die Variante mit weniger GPU-Kernen auch eine geringere Bandbreite. Ob das bei der 32-Core-GPU dieser Konfiguration ebenfalls zutrifft, geht aus den Händlerangaben nicht hervor. Rechne bei deinen Erwartungen an Tok/s also lieber mit etwas Puffer.
Welche Sprachmodelle in 36 GB passen
Der gemeinsame Speicher teilt sich zwischen macOS, deinen Apps und dem Modell auf. Außerdem gibt macOS der GPU standardmäßig nicht die vollen 36 GB frei. Realistisch bleiben also rund 20 bis 25 GB für Modell und Kontext. Damit liegt der Sweet Spot bei Modellen um 27 bis 31 Milliarden Parameter in Quantisierung Q4.
| Modellklasse | Beispiel | Passt in 36 GB? | Einordnung |
|---|---|---|---|
| ~27B, Q4 | Qwen 3.8-27B (rund 16 GB) | Ja, mit Platz für Kontext | Laut heise in mehreren Benchmarks vor Claude Opus 4.6 |
| ~31B, Q4 | Gemma 4 31B | Ja, mit Platz für Kontext | Multimodal, 256K Kontext möglich, aber nicht voll ausschöpfbar |
| MoE mittel | Gemma 4 26B A4B | Ja | Nur rund 4B aktive Parameter, dadurch spürbar schneller |
| 70B und mehr | große offene Modelle | Nein | Erst ab der Konfiguration mit 128 GB sinnvoll |
Die Grenze ist hart. Ab 70B ist Schluss, und daran ändert auch aggressive Quantisierung wenig, weil die Qualität bei sehr niedriger Bitzahl deutlich leidet. Auch lange Kontexte belasten den Arbeitsspeicher. Ein 27B-Modell passt locker hinein, ein Kontext von mehreren hunderttausend Token aber nicht mehr. Wer große Codebasen oder ganze Dokumentensammlungen am Stück verarbeiten will, stößt deshalb früher an die Grenze als an die Rechenleistung.
Bei Bildmodellen wie Flux.2 oder Z-Image zeigt der gemeinsame Speicher einen echten Vorteil. Auf Windows-Rechnern mit kleiner Grafikkarte musst du in ComfyUI oft auf Turbo-Varianten, FP8-Präzision oder ausgelagerte Modellteile ausweichen, damit alles in den Grafikspeicher passt. Der ASUS ROG GR70 ist ein typisches Beispiel. Seine RTX 5070 Laptop-GPU hat nur 8 GB VRAM, obwohl das von igorslab geprüfte System 64 GB Arbeitsspeicher mitbrachte.
Im Mac Studio stehen dem Bildmodell dagegen große Teile der 36 GB direkt zur Verfügung. Du kannst damit eher in höherer Präzision rechnen, größere Auflösungen wählen oder Text-Encoder und Bildmodell gleichzeitig geladen lassen. Bei der reinen Geschwindigkeit pro Bild ist eine Nvidia-Grafikkarte mit CUDA allerdings oft im Vorteil. Der Mac gewinnt bei der Modellgröße, nicht unbedingt bei der Rechenzeit.
| Configuration | M5 Max, 18‑Core CPU und 32‑Core GPU, 36GB RAM, 512 GB SSD |
|---|---|
| Prozessor | Apple M5 Max 18-Core |
| Arbeitsspeicher (RAM/VRAM) | 36 GB |
| Speicherbandbreite | 460 GB/s |
macOS, Apple Intelligence und KI-Software
Für lokale KI musst du auf dem Mac Studio wenig einrichten. llama.cpp läuft nativ auf Apple Silicon und nutzt über Metal die GPU und den gemeinsamen Arbeitsspeicher direkt. Ein Treiber-Setup wie bei Nvidia-Karten fällt weg, ebenso die Frage, welche CUDA-Version zu welchem Framework passt. Dass aktuelle Modelle auf dieser Chip-Generation laufen, ist belegt: Laut dev.to lief Qwen 3.8-27B als Unsloth-GGUF in der Quantisierung UD-Q4KXL auf einem MacBook Pro M5. Dort kamen MTP Speculative Decoding und ein auf 512K erweiterter Kontext zum Einsatz, allerdings mit 128 GB Unified Memory. Mit 36 GB läuft dasselbe Modell auch, nur mit deutlich kürzerem Kontext.
Bequemer geht es mit Gemma 4. Seit April 2026 liegt das Modell auf Docker Hub und lässt sich mit docker model pull gemma4 laden. Ein Terminal-Befehl reicht also, und das Sprachmodell steht als lokaler Dienst bereit. Interessant für den Mac sind vor allem die mittleren Größen: Die 26B-A4B-Variante ist ein Mixture-of-Experts-Modell, bei dem pro Token nur ein Teil der Gewichte aktiv ist. Dichte Modelle wie Gemma 4 31B hängen dagegen stärker an der Speicherbandbreite. Gemma 4 steht unter Apache 2.0 und darf daher auch kommerziell genutzt werden, was für Agenturen und Freelancer zählt.
Apple Intelligence: Alltagshilfe, kein Ersatz für eigene Modelle
Ab Werk bringt macOS Siri AI und Apple Intelligence mit, systemweit eingebunden in Mail, Notizen, Fotos und andere Apple-Apps. Laut Apple versteht Siri AI persönlichen Kontext und hat breites Weltwissen. Für Zusammenfassungen, Umformulierungen oder die Suche in eigenen Dateien brauchst du also kein eigenes Modell. Bei der Wahl des Modells, bei der Quantisierung und der Kontextlänge hast du allerdings keinen Einfluss. Wer mit einem bestimmten Qwen- oder Gemma-Modell programmieren, Dokumente auswerten oder Agenten bauen will, landet trotzdem bei llama.cpp, Docker oder MLX. Apple Intelligence und eigene Modelle laufen parallel, belegen aber Arbeitsspeicher aus demselben 36-GB-Topf.
Wo die Grenze zu CUDA-Systemen liegt
Der wichtigste Unterschied zu einem Windows- oder Linux-Rechner mit Nvidia-Grafikkarte ist nicht die Rechenleistung, sondern das Ökosystem. CUDA gibt es nur auf Nvidia-Hardware, und viele Forschungsprojekte, Trainingsskripte und Bildgenerierungs-Workflows sind zuerst oder ausschließlich darauf optimiert. Wie stark der Backend-Unterschied ausfällt, zeigt igorslab: Auf einem Mini-PC mit RTX 5070 Laptop-GPU war llama.cpp mit CUDA schneller als mit Vulkan. Auf dem Mac stehen dir dafür Metal und Apples Framework MLX zur Verfügung, aber nicht jedes Werkzeug unterstützt sie gleich gut.
| Aufgabe | Auf dem Mac Studio | Worauf du achten solltest |
|---|---|---|
| Sprachmodell-Inferenz (Qwen, Gemma) | llama.cpp mit Metal, Docker, MLX | Gut unterstützt, Grenze ist die Modellgröße in 36 GB |
| Systemweite Textassistenz | Apple Intelligence, Siri AI | Keine Wahl des Modells, nur Apple-Funktionen |
| Bildgenerierung (z. B. Flux.2, Z-Image in ComfyUI) | Läuft in der Regel, aber ohne CUDA-Beschleunigung | Custom Nodes und FP8-Varianten setzen oft CUDA voraus |
| Fine-Tuning und Training | Mit MLX möglich | Viele Anleitungen und Bibliotheken sind CUDA-only |
| Kommerzielle CUDA-Software | Nicht lauffähig | Vor dem Kauf eine Mac-Version oder Alternative suchen |
Für die Kaufentscheidung heißt das: Wer vor allem Sprachmodelle ausführt, verliert auf dem Mac praktisch nichts. Wer dagegen ein bestimmtes Repository von GitHub nutzen will, eine Bildpipeline mit speziellen Erweiterungen fährt oder eigene Modelle trainiert, sollte vor dem Kauf prüfen, ob es eine Metal- oder MLX-Version gibt. Ein Rechner mit Nvidia-Grafikkarte ist in diesen Nischen schlicht unkomplizierter.
Vor dem Kauf prüfen
Liste die drei bis fünf KI-Werkzeuge auf, die du wirklich täglich nutzen willst, und suche in deren Dokumentation oder im Issue-Tracker nach „Metal“, „MPS“ oder „MLX“. Steht dort nur „CUDA required“ oder „NVIDIA GPU“, ist der Mac Studio für diesen Zweck die falsche Plattform, egal wie schnell der M5 Max ist. Für reine Sprachmodelle über llama.cpp oder Docker kannst du dir die Prüfung sparen.
Mac Studio im Vergleich zu Mac mini, Gaming-PC und Mini-PC mit 192 GB
| Produkt | Bewertung | Preis | Kaufen |
|---|---|---|---|
 Nvidia GeForce RTX 5090 32 GB GDDR7 an 512 Bit: 27B-Modelle wie Qwen 3.8 laufen komplett im VRAM +32 GB VRAM: 27B-Modelle samt Kontext+512 Bit: zügigere Token-Ausgabe -Preis weit über der RX 9070 XT | 9.995,00 € | Kaufen → | |
 Apple Mac Studio (M5 Max, 36 GB) 36 GB Unified Memory für 27B-Modelle wie Qwen 3.8 – leise auf dem Schreibtisch +36 GB: Qwen 3.8-27B passt komplett+Neural Accelerator je GPU-Kern -36 GB verlötet, später nicht aufrüstbar | 2.599,00 € | Kaufen → | |
 Bosgame M5 (Ryzen AI Max+ 395, 128 GB, 2 TB) 128 GB Unified Memory im Mini-PC: Platz für große lokale LLMs +128 GB Unified Memory für große LLMs+Radeon 8060S: Bildgenerierung ohne Grafikkarte -RAM verlötet, später nicht aufrüstbar | 3.699,00 € | Kaufen → | |
 Apple Mac mini (M5 Pro, 24 GB, 512 GB) Top-Empfehlung 24 GB Unified Memory und 307 GB/s: lokale 27B-Modelle in einem 12,7-cm-Würfel +24 GB: 27B-Modelle als 4-Bit-Quant+307 GB/s: zügigere Token-Ausgabe -24 GB: wenig Puffer für Langkontext | 1.699,00 € | Kaufen → | |
| Apple Mac mini (M6, 24 GB, 512 GB) 24 GB Unified Memory: Qwen 3.8-27B im 4-Bit-Quant auf dem Schreibtisch +24 GB: 27B-Modelle als 4-Bit-Quant+Neural Accelerator pro GPU-Kern beschleunigt KI -24 GB: wenig Reserve für langen Kontext | 1.299,00 € | Kaufen → | |
 GEEKOM IT15 (Core Ultra 9 285H, 32 GB, 1 TB) Core Ultra 9 285H und 32 GB DDR5: kompakter Einstieg für kleine lokale KI-Modelle +Zwei SODIMM-Slots: RAM später aufrüstbar+Zweiter M.2-Slot für Modellbibliothek -Keine eigene GPU: größere LLMs laufen zäh | 1.399,00 € | Kaufen → |
Preise vom 16. Nov. 2026, sie können sich inzwischen geändert haben.
Für wen sich die 36-GB-Version lohnt
Bei dieser Konfiguration entscheidet weniger die Frage „Mac oder nicht“ als die Frage, wie groß deine KI-Pläne in den nächsten Jahren werden. Arbeitsspeicher und SSD sind fest verlötet. Was du heute für 2.599 € kaufst, bleibt die Obergrenze für die gesamte Nutzungsdauer. Die passenden und die unpassenden Käufer lassen sich deshalb recht klar trennen.
Gut geeignet für
- Video-Editoren, 3D-Artists und Fotografen, die nebenbei Sprachmodelle bis etwa 27–31B lokal für Coding oder Texte nutzen wollen
- alle, die bereits iPhone und iPad nutzen und einen leisen, kompakten Rechner für den Schreibtisch suchen
- Kreative, die einen SDXC-Kartenleser, HDMI und vier Thunderbolt-5-Anschlüsse ohne Adapter direkt am Gerät brauchen
Nicht geeignet für
- alle, die 70B-Modelle oder lange Kontexte bis 512K Token planen. Dafür sind 128 GB nötig.
- Gelegenheitsnutzer von KI, die mit dem Mac mini M6 ab 1.049 € deutlich günstiger fahren
- Nutzer, deren Werkzeuge zwingend CUDA voraussetzen
Passt: Kreative mit KI-Nebenjob
Der ideale Käufer verdient sein Geld mit Schnitt, 3D oder Bildbearbeitung und nutzt ein Sprachmodell als Werkzeug nebenher. Für diese Mischung sind die 36 GB stimmig: Neben einem 16 GB großen Qwen 3.8-27B in Q4 bleibt noch Luft für den Kontext und für macOS. Gemma 4 31B ist die obere Grenze dessen, was in Q4 sinnvoll hineinpasst.
Für einen Code-Assistenten, das Umformulieren von Texten oder Zusammenfassungen von Projektnotizen reicht das gut. Rechne aber damit, dass beides gleichzeitig eng wird. Wenn ein 27B-Modell geladen ist und parallel eine große Timeline in Final Cut Pro oder eine komplexe Szene in Blender offen ist, teilen sich beide Programme denselben gemeinsamen Speicher. In der Praxis bedeutet das: das Modell beenden, bevor du rendern lässt, oder zu einer kleineren Gemma-4-Variante wie 12B greifen.
Passt: wer schon im Apple-Ökosystem lebt
Der zweite klare Fall sind Nutzer, die iPhone und iPad bereits täglich nutzen. Kopieren auf dem iPhone und Einfügen am Mac, Sidecar mit dem iPad als Zweitbildschirm, Nachrichten und FaceTime am Schreibtisch: Dazu kommt das kompakte, laut Apple auch unter Last leise Gehäuse. Für Schreibtische im Wohnzimmer, kleine Studios oder Tonaufnahmen ist das ein echtes Argument gegenüber einem Gaming-PC mit lauter Grafikkarte.
Lieber überspringen: wer KI ernsthaft skalieren will
Wer 70B-Modelle laden möchte, scheitert an 36 GB schon bei den Gewichten. Selbst in Q4 sind sie deutlich größer als der gesamte Arbeitsspeicher. Ähnlich sieht es bei langen Kontexten aus. Der in den Quellen beschriebene Lauf von Qwen 3.8-27B mit per YaRN auf 512K gestrecktem Kontext lief auf einem MacBook Pro M5 mit 128 GB, weil der Zwischenspeicher für so viele Token selbst etliche Gigabyte belegt. Wenn das dein Ziel ist, nimm direkt die 128-GB-Konfiguration des M5 Max. Hier fehlt am Ende nicht Rechenleistung, sondern Speicher, und den kannst du später nicht nachrüsten.
Lieber überspringen: Gelegenheitsnutzer
Wenn du KI nur ab und zu nutzt, etwa für einen Chat oder ein schnelles Bildskript, bezahlst du beim Mac Studio für Reserven, die du nie abrufst. Der Mac mini M6 beginnt bei 1.049 € und ist damit rund 1.550 € günstiger. Tom's Guide empfiehlt ihn derzeit als besten Mini-PC. In der von ComputerBase geprüften Ausstattung mit 32 GB – die allerdings über dem Einstiegspreis liegt – läuft auch dort ein 27B-Modell in Q4. Dir fehlen die breitere Anschlussauswahl und die höhere Speicherbandbreite des M5 Max, beides ist für gelegentliche Nutzung aber verzichtbar.
Eine Ausnahme gibt es auch auf der anderen Seite: Wenn deine Werkzeuge nur mit CUDA laufen, hilft dir keine Mac-Konfiguration weiter. Dann ist ein PC mit Nvidia-Grafikkarte die ehrlichere Wahl.
Preis-Leistung und Fazit
2.599,00 € für 18 CPU-Kerne, 32 GPU-Kerne, 36 GB Unified Memory und 512 GB SSD ist kein Schnäppchen. Im aktuellen Marktumfeld ist der Preis aber nachvollziehbar. KI-taugliche Hardware ist massiv teurer geworden: Eine vier Jahre alte RTX 4090 wechselt laut heise auf Kleinanzeigen für rund 4.000 € den Besitzer, neu kostet sie bis zu 5.000 €. Dabei hat sie nur 24 GB Grafikspeicher und braucht noch einen kompletten PC drumherum. Der Mac Studio bietet für deutlich weniger Geld mehr nutzbaren Speicher für Sprachmodelle, einen leisen Betrieb und eine Plattform, die bei Video und 3D ohnehin zu den stärksten gehört.
Wo das Geld gut angelegt ist und wo nicht
Die ehrliche Rechnung hängt am Arbeitsspeicher. Lokale Sprachmodelle liegen laut heise nur noch etwa ein halbes Jahr hinter der Cloud-Spitze wie Claude Opus 5.5. Mit 36 GB bildest du diese aktuelle Mittelklasse gut ab, inklusive Platz für Kontext und offene Programme. Die Reserve ist allerdings knapp. Kommen mit Qwen 4 und seinen Nachfolgern größere Modelle oder längere Kontexte, stößt die Basisversion an ihre Grenze. Nachrüsten kannst du nicht.
| Szenario | Sinnvolle Wahl | Begründung |
|---|---|---|
| Video, 3D, Foto, dazu gelegentlich ein 27B-Modell | Mac Studio M5 Max mit 36 GB | Volle Chip-Leistung, 614 GB/s Bandbreite, genug RAM für Q4-Modelle bis etwa 27B |
| Lokale KI als Hauptzweck, 70B-Modelle, lange Kontexte | Mac Studio M5 Max mit 128 GB | Gleicher Chip, aber Spielraum für die nächste Modellgeneration |
| Einstieg, Office, kleinere Modelle | Mac mini M6 ab 1.049 € | Günstigster Einstieg; mit 32 GB laufen auch 27B-Modelle in Q4 |
| Lokale KI unter Windows, Gaming nebenbei | Gaming-PC mit Radeon RX 9070 XT (rund 920 €) oder Nvidia-Karte für CUDA-Werkzeuge | Laut heise auch fürs Coding brauchbar, aber lauter und mit weniger Grafikspeicher |
| Sehr große Modelle mit über 100B Parametern | Mini-PC mit 192 GB, z. B. GMKtec EVO-X5 Pro | Ab £5.299, also mehr als das Doppelte und nicht in derselben Preisklasse |
Der Mac mini M6 ist für viele die vernünftigere Wahl, wenn du keine hohe GPU-Last hast. Der Mac Studio rechtfertigt seinen Aufpreis erst durch die 32 GPU-Kerne, die höhere Speicherbandbreite, die vier Thunderbolt-5-Anschlüsse und eine Kühlung, die auch bei langen Renderjobs leise bleibt.
Lieferbarkeit vor dem Kauf prüfen
Wegen der Knappheit bei Speicherchips waren laut ifun.de viele Mac-mini-Konfigurationen monatelang kaum lieferbar. Schau deshalb vor dem Kauf auf die Lieferzeit deiner Wunschkonfiguration. Greif aber nicht nur wegen einer kürzeren Wartezeit zur kleineren Variante, wenn du eigentlich mehr Arbeitsspeicher brauchst.
Der teuerste Fehler: zweimal kaufen
Wer heute 36 GB nimmt und in einem Jahr für Qwen 4 oder 70B-Modelle aufrüsten will, muss einen zweiten Rechner anschaffen. Den Arbeitsspeicher kannst du nicht nachrüsten. Thunderbolt 5 mit RDMA erlaubt zwar das Koppeln mehrerer Macs, das ist aber teurer als die passende Konfiguration gleich beim Kauf.
Unsere Empfehlung
Kaufen, wenn Kreativarbeit im Vordergrund steht. Bist du vor allem mit Video-Schnitt, 3D-Szenen oder großen Fotobibliotheken beschäftigt und willst nebenbei Sprachmodelle bis etwa 27B lokal nutzen, bekommst du für 2.599,00 € einen kompakten, leisen und sehr schnellen Rechner ohne spürbare Kompromisse.
Steht KI im Mittelpunkt, greif lieber zur 128-GB-Variante. Der Aufpreis tut beim Kauf weh. Er ist aber günstiger, als später einen zweiten Rechner zu kaufen, weil die Basisversion bei der nächsten Modellgeneration an Speichergrenzen stößt, lange bevor der M5 Max ausgelastet ist.
Ein starker, leiser Rechner für Kreative, der Sprachmodelle der aktuellen Mittelklasse problemlos lokal ausführt. Wer lokale KI ernsthaft skalieren will, sollte gleich mehr Arbeitsspeicher einplanen.
Hinweis: Diese Seite enthält Affiliate-Links. Kaufst du über einen dieser Links, erhalten wir eine kleine Provision. Für dich ändert sich am Preis nichts, und unsere Einschätzung bleibt davon unabhängig.