KI-Hardware für zuhause: So findest du den richtigen Rechner für lokale LLMs
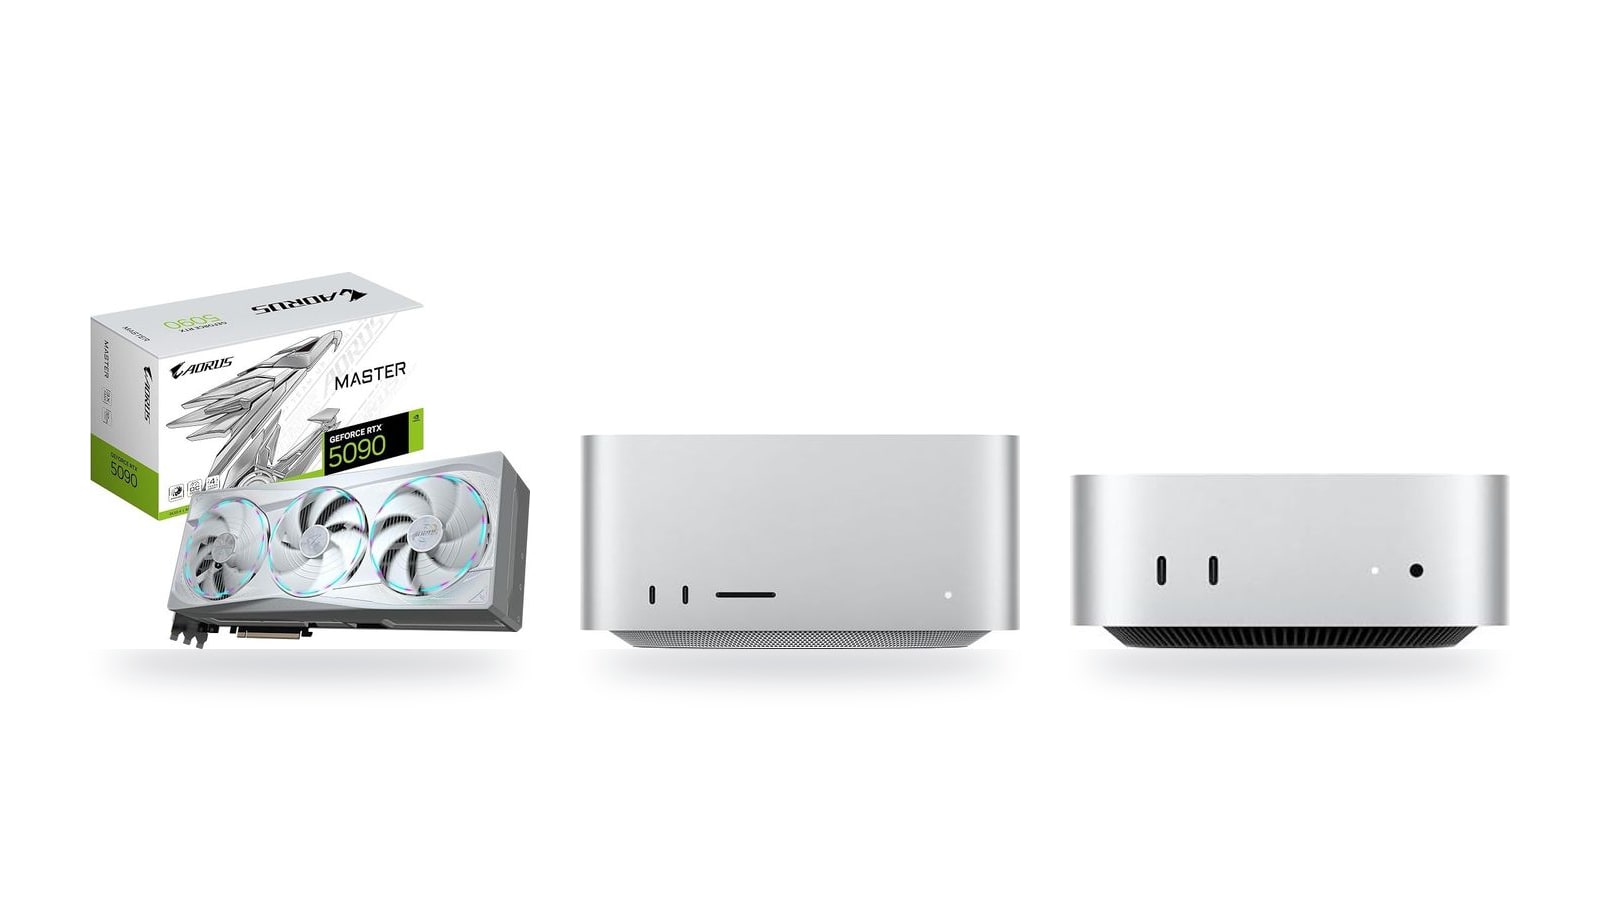
Ein lokales Sprachmodell mit rund 16 GB Gewichten schlägt inzwischen in mehreren Benchmarks Claude Opus 4.6, das im Februar 2026 noch das führende Cloud-Modell war. Die entscheidende Frage ist deshalb nicht mehr, ob dein Rechner lokale KI kann, sondern wie viel Arbeitsspeicher er dafür mitbringen muss.
Lokale KI ist 2026 kein Bastelprojekt mehr. Das Modell hinter dieser Aussage heißt Qwen 3.8-27B, und laut heise läuft es auf einem gewöhnlichen Gaming-PC. Du bekommst also Antworten auf dem Niveau des Cloud-Spitzenmodells vom Frühjahr, ohne dass deine Daten einen fremden Server sehen.
Was du gewinnst und was du aufgibst
Der Abstand zur Cloud ist kleiner geworden, aber er besteht weiterhin. Lokale Modelle liegen nach Einschätzung von heise etwa ein halbes Jahr hinter OpenAI, Anthropic und Google zurück. Das aktuelle Spitzenmodell Claude Opus 5.5 kann also mehr. Ein lokales Modell erreicht heute ungefähr das Niveau, das die Cloud im Frühjahr hatte. Für Coding, Zusammenfassungen, Recherche in eigenen Dokumenten oder einen Chat-Assistenten reicht das in den meisten Fällen.
Dafür bekommst du zwei handfeste Vorteile. Erstens verlassen deine Daten den Rechner nicht. Das zählt bei Kundenakten, Quellcode unter NDA oder privaten Notizen mehr als jeder Benchmark-Punkt. Zweitens fallen keine Abo-Kosten an. Du zahlst einmal für die Hardware und danach nur noch Strom. Wer täglich viel mit KI arbeitet, spart damit auf Dauer spürbar Geld.
Die Kennzahl, die beim Kauf zählt
Die meisten Kaufberater werben mit TOPS, Kernzahlen oder der NPU. Für Sprachmodelle sind das Nebenschauplätze. Ausschlaggebend sind zwei Werte rund um den Speicher:
| Kennzahl | Was sie bestimmt | Was passiert, wenn sie zu knapp ist |
|---|---|---|
| Arbeitsspeicher (RAM, VRAM oder Unified Memory) | Welche Modellgröße und welche Kontextlänge überhaupt laufen | Das Modell lädt nicht oder lagert aus, die Leistung bricht massiv ein |
| Speicherbandbreite (GB/s) | Wie viele Token pro Sekunde das Modell erzeugt | Die Antworten tröpfeln Wort für Wort, statt flüssig zu erscheinen |
Wie beide Werte zusammenspielen, rechnen wir weiter unten konkret vor. Für den Anfang reicht eine Konsequenz: Eine Grafikkarte mit 8 GB VRAM kann sehr schnell sein und trotzdem an einem 27B-Modell scheitern, weil es schlicht nicht hineinpasst.
Qwen 4 wird jeden Moment erwartet und war beim Videodreh von heise noch nicht erschienen. Neue Modellgenerationen wachsen oft in der Größe, verlangen längere Kontexte oder kommen als Mixture-of-Experts-Varianten mit mehr Gesamtparametern. Wer heute genau 16 GB für Qwen 3.8-27B kauft, hat beim nächsten Modell womöglich keinen Spielraum mehr. Ein paar Gigabyte zusätzlicher Arbeitsspeicher sind die günstigste Versicherung gegen einen vorzeitigen Neukauf. Nachrüsten lässt sich Unified Memory bei den meisten Geräten nämlich nicht.
Die Reihenfolge lautet also: Lege zuerst fest, welches Modell du nutzen willst. Daraus ergibt sich der Speicherbedarf, und erst danach wählst du Plattform und Budget. Die Tabelle unten sortiert die passenden Geräte nach Preis, die Abschnitte danach zeigen, wie du den Speicherbedarf berechnest.
Empfehlungen nach Budget: unter 1.500 €, bis 3.000 € und darüber
| Produkt | Bewertung | Preis | Kaufen |
|---|---|---|---|
 Nvidia GeForce RTX 5090 32 GB GDDR7 an 512 Bit: 27B-Modelle wie Qwen 3.8 laufen komplett im VRAM +32 GB VRAM: 27B-Modelle samt Kontext+512 Bit: zügigere Token-Ausgabe -Preis weit über der RX 9070 XT | 9.995,00 € | Kaufen → | |
 Apple Mac Studio (M5 Max, 36 GB) 36 GB Unified Memory für 27B-Modelle wie Qwen 3.8 – leise auf dem Schreibtisch +36 GB: Qwen 3.8-27B passt komplett+Neural Accelerator je GPU-Kern -36 GB verlötet, später nicht aufrüstbar | 2.599,00 € | Kaufen → | |
 Bosgame M5 (Ryzen AI Max+ 395, 128 GB, 2 TB) 128 GB Unified Memory im Mini-PC: Platz für große lokale LLMs +128 GB Unified Memory für große LLMs+Radeon 8060S: Bildgenerierung ohne Grafikkarte -RAM verlötet, später nicht aufrüstbar | 3.699,00 € | Kaufen → | |
 Apple Mac mini (M5 Pro, 24 GB, 512 GB) Top-Empfehlung 24 GB Unified Memory und 307 GB/s: lokale 27B-Modelle in einem 12,7-cm-Würfel +24 GB: 27B-Modelle als 4-Bit-Quant+307 GB/s: zügigere Token-Ausgabe -24 GB: wenig Puffer für Langkontext | 1.699,00 € | Kaufen → | |
| Apple Mac mini (M6, 24 GB, 512 GB) 24 GB Unified Memory: Qwen 3.8-27B im 4-Bit-Quant auf dem Schreibtisch +24 GB: 27B-Modelle als 4-Bit-Quant+Neural Accelerator pro GPU-Kern beschleunigt KI -24 GB: wenig Reserve für langen Kontext | 1.299,00 € | Kaufen → | |
 GEEKOM IT15 (Core Ultra 9 285H, 32 GB, 1 TB) Core Ultra 9 285H und 32 GB DDR5: kompakter Einstieg für kleine lokale KI-Modelle +Zwei SODIMM-Slots: RAM später aufrüstbar+Zweiter M.2-Slot für Modellbibliothek -Keine eigene GPU: größere LLMs laufen zäh | 1.399,00 € | Kaufen → |
Preise vom 16. Nov. 2026, sie können sich inzwischen geändert haben.
Speicher und Bandbreite: die zwei Zahlen, die wirklich zählen
Bevor du Prozessoren, NPU-TOPS oder Kernzahlen vergleichst, solltest du zwei Fragen klären. Wie viel Arbeitsspeicher braucht dein Zielmodell? Und wie schnell kann die Hardware diesen Speicher auslesen? Die erste Zahl entscheidet, ob ein Modell überhaupt startet. Die zweite entscheidet, ob du beim Antworten zusehen musst oder flüssig arbeiten kannst.
Faustregel: Parameter × Quantisierung + Kontext
Bei Q4-Quantisierung, also rund 4 Bit pro Gewicht, brauchst du etwa 0,6 GB pro Milliarde Parameter. Ein 27B-Modell landet damit bei rund 16 GB. Ein typisches Beispiel ist der Unsloth-Quant UD-Q4KXL von Qwen 3.8-27B: Die GGUF-Datei für llama.cpp wiegt etwa 16 GB. Mit Q8 verdoppelt sich der Bedarf ungefähr, mit unquantisierten 16-Bit-Gewichten vervierfacht er sich. Q4 ist deshalb der übliche Kompromiss für Heimhardware.
Zu den Gewichten kommt der KV-Cache für den Kontext. Das ist der Speicher, in dem das Modell Eingabe und bisherigen Verlauf vorhält. Bei normalen Chats und Coding-Sitzungen fallen dafür einige GB an. Plane deshalb nie nur die Modelldatei ein. Betriebssystem, Browser und IDE wollen ebenfalls ihren Teil vom Arbeitsspeicher, vor allem bei Unified Memory, wo sich CPU und GPU denselben Speicher teilen.
Qwen 3.8-27B bringt nativ 262.144 Token Kontext mit. Auf einem MacBook Pro M5 mit 128 GB gemeinsamem Speicher ließ sich der Kontext per YaRN sogar auf 512K strecken. Das zeigt die Größenordnung: Wer ganze Codebasen oder Dokumentensammlungen in einen Prompt packen will, braucht nicht 24, sondern eher 64 bis 128 GB. Das Modell selbst bleibt dabei gleich groß, nur der Kontext wächst.
Gemma 4 als Orientierung für deine Speicherklasse
Googles Gemma-4-Familie deckt alle Hardwareklassen ab. Sie eignet sich daher gut als Messlatte für die Frage, was auf deinem Rechner sinnvoll läuft:
| Modell | Zielhardware | Kontext | Typischer Rechner |
|---|---|---|---|
| E2B, E4B | schwache Hardware, Notebooks, 8-GB-Grafikkarten | 128K | Geekom A5 Pro mit 16 GB |
| 12B | Grafikkarten und Mini-PCs mit 16–32 GB | 256K | Minisforum UM890 Pro, GEEKOM IT15 |
| 26B A4B (MoE) | Workstations, Unified Memory ab 24–32 GB | 256K | Apple Mac mini (M6, 24 GB) und größer |
| 31B | Grafikkarten mit viel VRAM, große Unified-Memory-Systeme | 256K | Nvidia GeForce RTX 5090, Apple Mac Studio (M5 Max, 36 GB) |
Eine Besonderheit hat das 26B A4B. Als Mixture-of-Experts-Modell muss es komplett in den Speicher passen, aktiviert pro Token aber nur rund 4 Milliarden Parameter. Es braucht also Speicherplatz wie ein großes Modell und erzeugt Token fast so schnell wie ein kleines. Auf Hardware mit viel, aber eher langsamem Speicher ist das oft die beste Wahl.
Welche Kennzahl welche Phase beschleunigt
Ein Sprachmodell arbeitet in zwei Phasen, und jede hängt an einer anderen Kennzahl:
| Merkmal | Prompt-Processing (Einlesen) | Generierung (Ausgabe) |
|---|---|---|
| Was passiert | Das Modell verarbeitet deine gesamte Eingabe parallel | Das Modell erzeugt Token für Token nacheinander |
| Engpass | Rechenleistung (GPU-Kerne, Tensor-Einheiten) | Speicherbandbreite (GB/s) |
| Spürbar bei | langen Dokumenten, großen Codebasen, RAG | jeder Antwort, vor allem bei langen Ausgaben |
| Messgröße | Token pro Sekunde beim Prefill, Wartezeit bis zum ersten Token | Token pro Sekunde (Tok/s) |
| Stark hier | dedizierte Grafikkarten wie die RTX 5090 | Systeme mit breiter Speicheranbindung, z. B. Mac Studio mit M5 Max |
Warum die Bandbreite die Generierung begrenzt, zeigt eine einfache Rechnung. Für jedes einzelne Token liest die Hardware die aktiven Gewichte einmal komplett aus dem Speicher. Bei 16 GB Gewichten und 256 GB/s Bandbreite liegt die theoretische Obergrenze also bei rund 16 Tok/s. In der Praxis landest du etwas darunter. Doppelte Bandbreite heißt grob doppelt so viele Token pro Sekunde, mehr GPU-Kerne helfen hier kaum. Tricks wie das MTP-Speculative-Decoding von Qwen 3.8-27B holen zusätzlich etwas heraus, ändern aber nichts am Grundprinzip.
Beim Prompt-Processing ist es umgekehrt. Hier zählt rohe Rechenleistung. Deshalb liest eine Nvidia-Grafikkarte einen 100.000-Token-Prompt deutlich schneller ein als ein Mini-PC mit gleich viel, aber langsamerem Unified Memory. Für deinen Kauf bedeutet das: Wenn du vor allem chattest, priorisiere Bandbreite. Wenn du regelmäßig lange Dokumente oder ganze Repositories einliest, achte zusätzlich auf GPU-Rechenleistung. In beiden Fällen gilt aber zuerst: Das Modell muss in den Speicher passen.
Die vier Plattformen im Überblick
Für lokale KI gibt es 2026 im Kern vier Bauweisen. Drei davon setzen auf Unified Memory: CPU und GPU greifen auf denselben Arbeitsspeicher zu, das Sprachmodell kann also fast den ganzen RAM belegen. Die vierte ist der klassische PC mit eigener Grafikkarte. Dort zählt allein der Grafikspeicher (VRAM), und der ist knapp und teuer. Diese Grundentscheidung prägt alles Weitere: wie groß dein Zielmodell sein darf, wie schnell es antwortet und wie gut du später aufrüsten kannst.
- Apple Mac mini und Mac Studio – Gemeinsamer Speicher mit hoher Bandbreite, leise und sparsam. Der Mac Studio fasst bis zu 512 GB, mehrere Macs lassen sich per Thunderbolt 5 RDMA koppeln. Arbeitsspeicher lässt sich nicht nachrüsten.
- AMD Gorgon Halo – Der Ryzen AI Max+ PRO 495 mit Radeon 8065S bringt bis zu 192 GB Unified Memory in einen Mini-PC. Er löst Strix Halo ab, verlangt aber den höchsten Einstiegspreis aller Mini-PC-Lösungen.
- Nvidia RTX Spark (N1X) – Arm-Chip mit Blackwell-GPU und Unified Memory, dazu der CUDA-Softwarestapel. Bisher gibt es ihn nur in Notebooks, Desktop-Geräte kommen erst noch.
- Klassischer PC mit Grafikkarte – Hohe Rechenleistung pro Euro, und du kannst aufrüsten. Das Modell muss aber in den VRAM passen, und mehr VRAM wird schnell sehr teuer.
Apple: der bequemste Weg zu viel Speicher
Seit Ende August 2026 startet der Mac mini ab 1.049 €, mit M6 oder M5 Pro. Der Apple Mac mini (M6, 24 GB, 512 GB) für 1.299 € bietet 24 GB gemeinsamen Speicher. Das reicht für ein 27B-Modell in Q4 mit etwa 16 GB Gewichten, lässt für lange Kontexte aber nur wenig Luft. Der Apple Mac mini (M5 Pro, 24 GB, 512 GB) für 1.699 € hat gleich viel Arbeitsspeicher, aber mit 16 GPU-Kernen und dem Pro-Chip mehr Bandbreite. Er erzeugt also mehr Token pro Sekunde, kann aber kein größeres Modell laden.
Richtig interessant wird Apple beim Mac Studio. Schon der Apple Mac Studio (M5 Max, 36 GB) für 2.599 € schafft mehr Platz. Mit M5 Ultra fasst er bis zu 512 GB, und per Thunderbolt 5 RDMA kannst du mehrere Macs zu einem Cluster verbinden. Damit rücken auch Modelle weit jenseits von 200 Milliarden Parametern in Reichweite, die selbst in 192 GB nicht mehr passen. Den Nachteil kennst du: Der Speicher ist verlötet. Du musst also beim Kauf richtig planen, denn nachrüsten geht nicht.
AMD Gorgon Halo: maximaler Speicher im Mini-PC
Der Ryzen AI Max+ PRO 495 mit Radeon 8065S ist der direkte Nachfolger von Strix Halo. Er kommt in Mini-PCs mit bis zu 192 GB Unified Memory. Damit passen auch große Mixture-of-Experts-Modelle in ein Gehäuse von der Größe eines Buchs. Die ersten Geräte starten allerdings bei 5.299 £ bzw. 6.799 $. Wer weniger ausgeben will, greift zur Vorgängergeneration: Der Bosgame M5 (Ryzen AI Max+ 395, 128 GB, 2 TB) für 3.699 € nutzt noch Strix Halo. Mit 128 GB ist er für die meisten Modelle, die du heute lokal sinnvoll betreibst, trotzdem gut ausgestattet.
Die Schwäche liegt bei der Software. AMD läuft über ROCm oder Vulkan, das ist noch nicht so ausgereift wie CUDA oder Metal. Rechne damit, dass du bei neuen Modellen gelegentlich selbst nachhelfen musst.
Nvidia RTX Spark: das Versprechen von CUDA mit viel Speicher
Der N1X verbindet einen Arm-Prozessor mit einer Blackwell-GPU und Unified Memory. Er braucht keine CPU von AMD oder Intel und läuft unter Windows. Notebooks sind bereits erhältlich, kompakte Desktop-Rechner stehen kurz vor dem Marktstart. Damit wäre RTX Spark die erste Plattform, die viel gemeinsamen Speicher mit dem CUDA-Ökosystem verbindet, also der Software-Basis, auf die die meisten KI-Werkzeuge zuerst optimiert werden. Belastbare Preise und Ausstattungen der Desktop-Geräte stehen noch aus. Kauf deshalb nichts auf Verdacht.
Klassischer PC: schnell, aufrüstbar, aber durch den VRAM begrenzt
Laut heise reicht schon eine aktuelle AMD-Grafikkarte für rund 920 € in einem normalen Gaming-PC für sinnvolle KI-Arbeit, auch fürs Programmieren. Die Rechenleistung pro Euro ist hier unschlagbar. Und weil die meisten aktuellen Mini-ITX-Gehäuse volle 2- bis 3-Slot-Karten aufnehmen, muss so ein Rechner auch nicht groß sein. Die Grenze setzt der Grafikspeicher: Was nicht in den VRAM passt, wird stark ausgebremst. Am oberen Ende kostet die Nvidia GeForce RTX 5090 mit 32 GB GDDR7 derzeit 9.995 €. Für dasselbe Geld bekommst du bei Apple oder AMD ein Vielfaches an nutzbarem Speicher.
| Plattform | Maximal nutzbarer Speicher | Software | Aufrüstbar | Größte Stärke |
|---|---|---|---|---|
| Apple Mac mini / Mac Studio | bis 512 GB Unified Memory, Cluster möglich | Metal (llama.cpp, MLX) | nein | sehr große Modelle, leise und sparsam |
| AMD Gorgon Halo | bis 192 GB Unified Memory | ROCm, Vulkan | nein | viel Speicher im Mini-PC |
| Nvidia RTX Spark (N1X) | Unified Memory, Desktop-Ausstattung noch offen | CUDA | nein | CUDA plus gemeinsamer Speicher |
| PC mit Grafikkarte | VRAM der Karte, z. B. 32 GB bei der RTX 5090 | CUDA, ROCm, Vulkan | ja | Rechenleistung pro Euro |
Unterm Strich
Brauchst du viel Speicher für große Modelle, führt der Weg zu Apple oder AMD Gorgon Halo. Willst du möglichst viele Token pro Sekunde bei mittelgroßen Modellen und später aufrüsten können, ist der PC mit Grafikkarte die günstigste Wahl. RTX Spark solltest du im Blick behalten, solange es die Desktop-Geräte noch nicht gibt.
Die 8-GB-Falle und die Frage nach der Software
Kompakte Gaming-Mini-PCs mit Laptop-Grafikkarte sehen auf dem Datenblatt nach idealer KI-Hardware aus: schneller Prozessor, viel Arbeitsspeicher, eine aktuelle Nvidia-GPU. Bei lokalen Sprachmodellen zählt aber nicht der Arbeitsspeicher des Systems, sondern der Grafikspeicher (VRAM). Genau dort wird an mobilen Grafikchips gespart. Eine RTX 5070 Laptop hat nur 8 GB VRAM. Daran ändern auch 64 GB Arbeitsspeicher im selben Gehäuse nichts.
Warum 64 GB RAM dir hier wenig nützen
Igorslab hat einen solchen Mini-PC mit Ryzen 9 9955HX3D, RTX 5070 Laptop und 64 GiB RAM untersucht. Im KI-Center-Benchmark erreichte er 923 Punkte und löste 14 von 16 Reasoning-Aufgaben. Für kleine Modelle ist das ordentlich: Gemma 4 E4B in Q4-Quantisierung passt vollständig in die 8 GB und läuft flott. Ein 27B-Modell wie Qwen 3.8-27B braucht in Q4 allerdings rund 16 GB nur für die Gewichte, also doppelt so viel, wie die Karte bietet. Das gilt ebenso für Gemma 4 26B A4B und 31B.
llama.cpp kann zwar einen Teil der Schichten in den Arbeitsspeicher auslagern. Diese Schichten rechnet dann aber die CPU über die deutlich langsamere DDR5-Anbindung, und die Token pro Sekunde brechen spürbar ein. Anders als beim Unified Memory eines Mac mini oder des Bosgame M5 bilden RAM und VRAM hier zwei getrennte Speicher. Sie lassen sich nicht einfach zusammenzählen. Wenn dein Ziel ein Modell der 27B-Klasse ist, fährst du mit dem Apple Mac mini (M5 Pro, 24 GB) besser. Dort passt das Modell samt etwas Kontext komplett in den gemeinsamen Speicher. Willst du auf einer dedizierten Grafikkarte bleiben, brauchst du eine Nvidia GeForce RTX 5090 mit 32 GB GDDR7, die allerdings in einer ganz anderen Preisklasse liegt.
CUDA, Metal, ROCm, Vulkan: Die Software entscheidet mit
Die Hardware ist nur die halbe Rechnung. Ebenso wichtig ist, welches Backend deine KI-Software auf der jeweiligen Plattform nutzt:
| Plattform | Backend in llama.cpp | Einordnung |
|---|---|---|
| Nvidia (RTX, RTX Spark) | CUDA, alternativ Vulkan | Am weitesten verbreitet, neue Funktionen kommen meist hier zuerst |
| Apple Silicon (M5, M6) | Metal | Sehr gut unterstützt, eigene Optimierungen wie MLX |
| AMD (Radeon, Ryzen AI Max) | ROCm oder Vulkan | ROCm ist schneller, aber anspruchsvoller einzurichten, Vulkan läuft fast überall |
| Intel (Arc, integrierte Grafik) | Vulkan, SYCL | Funktioniert, bekommt Optimierungen aber oft später |
Wie groß der Unterschied sein kann, zeigt wieder igorslab: Mit Gemma 4 E4B in llama.cpp war CUDA schneller als Vulkan, und zwar auf identischer Hardware. Nvidia profitiert also von einem jahrelangen Software-Vorsprung. Bei gleichem Speicher bekommst du dort häufig mehr Tempo und weniger Bastelarbeit. Auf AMD-Systemen wie dem Bosgame M5 oder dem Minisforum UM890 Pro lohnt es sich dagegen, ROCm und Vulkan gegeneinander zu vergleichen, denn je nach Treiberstand liegt mal das eine, mal das andere vorn.
Wenn du dich nicht mit Backends beschäftigen willst, nimm den Docker Model Runner. Mit docker model pull gemma4 lädst du Gemma 4 direkt von Docker Hub und startest es ohne manuelles Kompilieren.
Bildgenerierung: Hier zählt jedes Gigabyte doppelt
Aktuelle Bildmodelle wie Flux.2 oder Z-Image laufen in der Regel in ComfyUI und belegen viel Grafikspeicher. Auf Karten mit wenig VRAM helfen Turbo-Versionen in FP8 oder BF16. Sie brauchen weniger Speicher und weniger Rechenschritte pro Bild, bei leichten Abstrichen an der Qualität. Mit 8 GB bist du damit aber auf diese abgespeckten Varianten festgelegt, während 24 GB und mehr dir die Wahl lassen.
Profi-Tipp
Richte ComfyUI am besten mit Python 3.13 in einer eigenen virtuellen Umgebung ein. Mit älteren oder brandneuen Python-Versionen fehlen öfter passende Pakete für PyTorch und die Erweiterungen. Prüfe außerdem vor dem Kauf, ob dein Zielmodell vollständig in den VRAM passt: Gewichte plus einige GB für Kontext oder Bildauflösung. Steht dort nur eine 8 vor dem „GB“, bleibst du bei Modellen bis etwa 4B Parametern.
Die Gleichung lautet also: Der Speicher legt fest, welches Modell überhaupt läuft. Bandbreite und Software legen fest, wie schnell. Ein Mini-PC mit 8-GB-Laptop-GPU eignet sich gut für Gemma 4 E4B und Bildgenerierung mit Turbo-Modellen, als Plattform für die 27B-Klasse taugt er nicht.
Marktlage, Stromverbrauch und Lautstärke
Wer gerade KI-Hardware kauft, zahlt einen Aufschlag für die Nachfrage. Seit lokale Sprachmodelle wie Qwen 3.8-27B ernsthaft nutzbar sind, haben sich die Preise für alles mit viel schnellem Speicher deutlich vom ursprünglichen Niveau entfernt. Am deutlichsten zeigt sich das bei einer Grafikkarte, die eigentlich schon zum alten Eisen gehören müsste.
- ca. 4.000 €so viel kostet eine vier Jahre alte RTX 4090 laut heise gebraucht auf Kleinanzeigen
- bis 5.000 €Neupreis der RTX 4090, sofern du überhaupt noch eine findest
- 1.769 €UVP der RTX 4090 zum Marktstart, also weniger als die Hälfte des heutigen Gebrauchtpreises
- 1.049 €neuer Einstiegspreis des Mac mini, zuvor lag er deutlich niedriger
Grafikkarten und Macs: teuer und oft knapp
Der Grund für den Ansturm: Die 24 GB Grafikspeicher (VRAM) der RTX 4090 reichen für ein 27B-Modell in Q4 samt Kontext. Deshalb ist eine gebrauchte Karte heute mehr als doppelt so teuer wie bei ihrem Start. Die Nvidia GeForce RTX 5090 mit 32 GB GDDR7 steht in unserem Katalog bei 9.995 €. Allein die Karte kostet damit mehr als ein Bosgame M5 mit 128 GB Unified Memory und kommt doch nur auf ein Viertel von dessen Arbeitsspeicher. Für reine LLM-Arbeit lohnt sich dieser Aufpreis nur, wenn du die rohe CUDA-Leistung tatsächlich brauchst, etwa für Bildgenerierung oder Training.
Auf der Apple-Seite war das Problem weniger der Preis als die Lieferbarkeit. Wegen der Knappheit bei Speicherchips waren viele Mac-mini-Konfigurationen monatelang kaum zu bekommen, besonders die mit viel gemeinsamem Speicher. Die Preise sind dabei mitgestiegen: Statt früher 699 € kostet der günstigste Mac mini jetzt 1.049 €, die beiden 24-GB-Modelle mit M6 und M5 Pro liegen bei 1.299 € bzw. 1.699 €. Prüfe vor dem Kauf den Liefertermin der genauen Konfiguration. Ein Upgrade auf mehr Arbeitsspeicher kann die Wartezeit spürbar verlängern.
Lohnt sich Warten?
Warten lohnt sich, wenn du auf RTX-Spark-Desktops schielst. Nvidias Arm-Blackwell-Chip N1X mit Unified Memory steckt bereits in Notebooks, kompakte Desktop-Rechner sollen in Kürze folgen. Wer CUDA und gemeinsamen Speicher in einem Gerät will, sollte die ersten Preise und Speicherausstattungen abwarten.
Qwen 4 ist dagegen kein Grund zum Warten, sondern zum Planen. Das Modell wird jeden Moment erwartet. Falls es mehr Arbeitsspeicher braucht als Qwen 3.8-27B, kaufst du mit 24 GB womöglich zu knapp. Die Lösung ist mehr Reserve beim Kauf, nicht ein späterer Kauf.
Wer heute konkret arbeiten will, muss nicht warten. Unified-Memory-Rechner sind solide Optionen und lassen dir Reserven. Der Bosgame M5 mit 128 GB fasst auch deutlich größere Modelle samt langem Kontext. Der Mac Studio mit M5 Max und 36 GB bietet hohe Bandbreite für das 27B-Segment. Qwen 3.8-27B wird auf deinem Rechner nicht schlechter, nur weil später ein Nachfolger erscheint.
Dauerbetrieb im Arbeitszimmer
Ein KI-Rechner, der als lokaler Server für Coding-Assistenten oder Dokumentensuche läuft, ist oft den ganzen Tag eingeschaltet. Dann zählen Platz, Lautstärke und Leistungsaufnahme mehr als ein paar Token pro Sekunde zusätzlich.
| Kriterium | Mini-PC mit Unified Memory | Tower mit großer Grafikkarte |
|---|---|---|
| Platzbedarf | passt neben den Monitor oder ins Regal | eigener Platz unter oder neben dem Schreibtisch |
| Lautstärke unter Last | meist leiser, ein kleiner Lüfterverbund | mehrere Gehäuselüfter plus Kühler der Grafikkarte |
| Leerlauf | sehr sparsam, gut für Dauerbetrieb | Grundlast von Mainboard, CPU und Karte summiert sich |
| Aufrüstbarkeit | Arbeitsspeicher meist fest verlötet | Grafikkarte später austauschbar |
Die Stromkosten hängen vor allem von der Leerlaufzeit ab, denn die meisten Stunden am Tag wartet der Rechner auf die nächste Anfrage. Eine Beispielrechnung zeigt die Größenordnung: Jeder Watt Mehrverbrauch im Dauerbetrieb ergibt rund 8,8 kWh im Jahr. Bei 35 Cent pro kWh kostet also jedes zusätzliche Watt Grundlast etwa 3 € jährlich. Ein Tower, der im Leerlauf 50 W mehr zieht als ein Mini-PC, kostet dich so rund 150 € pro Jahr extra.
Der Haken der kompakten Geräte ist die fehlende Aufrüstbarkeit. Beim Mac mini und bei den Ryzen-AI-Max-Mini-PCs bleibt der Arbeitsspeicher für immer so groß, wie du ihn kaufst. Deshalb solltest du hier eher eine Stufe größer wählen. Ein Tower lässt dir dagegen den Weg zur nächsten Grafikkarte offen, bindet dich aber an deren knappen VRAM. Steht der Rechner im Arbeitszimmer und läuft neben Videocalls oder konzentrierter Arbeit, spricht viel für den leisen Mini-PC.
Checkliste vor dem Kauf
Die meisten Fehlkäufe bei lokaler KI entstehen, weil die Reihenfolge nicht stimmt: Erst wird ein Rechner ausgesucht, dann wird geprüft, was darauf läuft. Dreh es um. Wenn du diese vier Schritte nacheinander abarbeitest, bleiben pro Budgetstufe meist nur noch ein oder zwei sinnvolle Kandidaten übrig.
- Zielmodell und Einsatzzweck festlegen. Entscheide, was du konkret tun willst: Chat, Coding, Arbeit mit langen Dokumenten, Bildgenerierung oder multimodale Eingaben wie Audio. Daraus folgt die Modellklasse. Für einfachen Chat und Zusammenfassungen reichen Gemma 4 E2B oder E4B. Für ernsthaftes Coding solltest du ein Modell der 27B-Klasse wie Qwen 3.8-27B einplanen. Für Bildmodelle wie Flux.2 oder Z-Image zählt vor allem der Grafikspeicher (VRAM). Für Audio-Eingaben kommen nur Gemma 4 E2B, E4B und 12B infrage.
- Speicherbedarf ausrechnen und Reserve einplanen. Die Formel lautet: Gewichte nach Quantisierung plus Kontext plus Betriebssystem. Qwen 3.8-27B belegt in Q4 rund 16 GB. Lange Kontexte kommen obendrauf, und zwar oft mit mehreren Gigabyte. Rechne danach mindestens ein Drittel Reserve dazu, denn Qwen 4 steht unmittelbar bevor, und neue Modelle werden selten kleiner.
- Plattform nach Bandbreite und Software wählen. Erst jetzt entscheidest du zwischen Mac, AMD-Unified-Memory, Nvidia-Grafikkarte oder einem klassischen Mini-PC. Die Speicherbandbreite bestimmt die Token pro Sekunde. Die Software entscheidet, ob dein Modell überhaupt sauber läuft: Metal auf dem Mac, CUDA bei Nvidia, ROCm oder Vulkan bei AMD.
- Budget, Lieferzeit, Lautstärke und Platz prüfen. Erst am Schluss kommen die praktischen Fragen: Passt der Preis, ist die Konfiguration lieferbar, stört das Lüftergeräusch am Schreibtisch, und hast du Platz für ein Gehäuse mit Grafikkarte?
Schritt 2 konkret: So rechnest du
Die folgende Übersicht zeigt den groben Bedarf. Die Werte sind Richtgrößen für Q4-Quantisierung und keine Messwerte. Sie reichen aber, um Fehlkäufe auszuschließen.
| Einsatzzweck | Typisches Modell | Grober Bedarf an Arbeitsspeicher bzw. VRAM | Sinnvolle Größe mit Reserve |
|---|---|---|---|
| Chat, Zusammenfassungen | Gemma 4 E4B | unter 8 GB | 16 GB |
| Coding, anspruchsvoller Chat | Qwen 3.8-27B (Q4) | ca. 16 GB plus Kontext | 32 GB |
| Lange Kontexte (256K und mehr) | Qwen 3.8-27B mit großem Kontext | deutlich über 32 GB | 64 bis 128 GB |
| Große MoE-Modelle | Modelle jenseits von 100B | weit über 64 GB | 128 GB und mehr |
An dieser Tabelle sieht man, warum die Grenze bei 24 GB so knapp ist. Der Mac mini mit M6 und der Mac mini mit M5 Pro haben beide 24 GB gemeinsamen Speicher. Ein 27B-Modell passt da hinein, aber macOS gibt der GPU nicht den kompletten Speicher frei. Für größere Kontexte und für das nächste Modell bleibt deshalb wenig Luft.
Der Minisforum UM890 Pro und der GEEKOM IT15 kommen jeweils mit 32 GB und haben dadurch etwas mehr Spielraum. Dafür ist ihre Speicherbandbreite spürbar niedriger, die Antworten kommen also langsamer. Der Geekom A5 Pro mit 16 GB bleibt klar in der Klasse von Gemma 4 E4B.
Schritt 3 und 4: Wo sich die Kandidaten trennen
Bei gleichem Speicher entscheidet die Bandbreite über den Alltag. Die Nvidia GeForce RTX 5090 bringt 32 GB GDDR7 mit und ist bei Modellen, die komplett in den Grafikspeicher passen, die schnellste Option im Vergleich. CUDA hat zudem die breiteste Software-Unterstützung.
Sobald ein Modell aber nicht mehr vollständig in die 32 GB passt, bricht das Tempo ein. Genau dort spielen der Bosgame M5 mit 128 GB Unified Memory und der Mac Studio mit M5 Max ihre Stärke aus. Der Mac Studio liefert mit 36 GB zwar deutlich weniger Speicher als der Bosgame M5, dafür aber mehr Bandbreite als die Mac minis.
Preis und Lieferzeit gehören auf die Liste
Rechne bei der RTX 5090 nicht nur den Kartenpreis ein. Du brauchst zusätzlich ein passendes Gehäuse, ein ausreichend starkes Netzteil und musst mit spürbarer Abwärme rechnen. Beim Mac kann eine bestimmte Speicherkonfiguration wegen der Knappheit bei Speicherchips wochenlang nicht lieferbar sein. Prüfe deshalb die Lieferzeit, bevor du dich auf eine Konfiguration festlegst.
Die letzten beiden Punkte, Lautstärke und Platz, sprechen oft für einen Mini-PC oder Mac. Ein Mac mini oder ein Bosgame M5 passt neben den Monitor. Ein Rechner mit RTX 5090 braucht dagegen mindestens ein Mini-ITX-Gehäuse für Karten mit zwei bis drei Slots und ist unter Volllast deutlich hörbar. Wenn du hauptsächlich nachts oder im Wohnzimmer arbeitest, kann dieser Punkt am Ende den Ausschlag geben, selbst wenn die Grafikkarte auf dem Papier schneller ist.
Häufig gestellte Fragen
Reichen 24 GB für Qwen 3.8-27B?
Ja, aber knapp. Die Gewichte belegen in der gängigen 4-Bit-Quantisierung (UD-Q4KXL) rund 16 GB. Dazu kommt der Speicher für den Kontext, und auf einem Mac teilen sich Betriebssystem, Browser und Editor denselben Arbeitsspeicher. Mit einem Mac mini M6 oder Mac mini M5 Pro mit je 24 GB Unified Memory kommst du für Chat und kürzere Coding-Sitzungen aus. Große Codebasen oder lange Dokumente im Kontext passen dann aber nicht mehr hinein.
Wer Qwen 3.8-27B ernsthaft mit langen Kontexten nutzen will, sollte mindestens 32 bis 36 GB einplanen, etwa beim Mac Studio mit M5 Max und 36 GB. Die volle Kontextlänge von 262.144 Token oder sogar die per YaRN erweiterten 512K brauchen Größenordnungen wie die 128 GB des Bosgame M5.
Mac oder PC mit Grafikkarte für lokale KI?
Das hängt davon ab, wie groß dein Modell ist und wie viel Geld du ausgeben willst. Eine Grafikkarte bietet sehr hohe Speicherbandbreite und mit CUDA die breiteste Software-Unterstützung. Ihr Grafikspeicher ist aber eine harte Grenze: Die Nvidia GeForce RTX 5090 hat 32 GB und kostet derzeit 9.995 €. Laut heise schafft aber schon eine AMD-Grafikkarte für rund 920 € in einem normalen Gaming-PC brauchbare Coding-Hilfe, solange das Modell in den Grafikspeicher passt.
Der Mac punktet mit Unified Memory zum deutlich niedrigeren Preis pro Gigabyte. Er ist leise, sparsam und läuft mit llama.cpp über Metal problemlos. Ein Mac Studio mit M5 Max und 36 GB kostet nur gut ein Viertel einer RTX 5090. Bei gleicher Speichergröße erzeugt die Grafikkarte die Token schneller, der Mac kann dafür größere Modelle überhaupt erst laden. Kurz gesagt: Für Modelle bis rund 30 GB inklusive Kontext und maximale Tok/s ist die Grafikkarte stärker, darüber ist der Mac oder ein AMD-Rechner mit viel gemeinsamem Speicher die bezahlbare Lösung.
Bringt eine NPU etwas für lokale Sprachmodelle?
Derzeit kaum. Gängige Werkzeuge wie llama.cpp, LM Studio oder Docker Model Runner rechnen auf der GPU, also über CUDA, Metal, Vulkan oder ROCm. Die NPU bleibt dabei meist ungenutzt. Angaben wie die „99 TOPS KI-Leistung" beim GEEKOM IT15 beziehen sich auf die gesamte Plattform und sagen wenig darüber, wie schnell ein Sprachmodell Text erzeugt.
Für die Generierung ist die Speicherbandbreite der Flaschenhals, nicht die Rechenleistung. Eine NPU hilft bei kleinen Aufgaben wie Hintergrundunschärfe in Videocalls oder Transkription, ist aber kein Kaufargument für LLMs. Achte stattdessen auf die Größe des Arbeitsspeichers und die Bandbreite.
Lohnt sich eine gebrauchte RTX 4090?
Zu den aktuellen Preisen eher nicht. Gebraucht kostet die vier Jahre alte Karte rund 4.000 €, mehr als das Doppelte ihrer UVP. Dafür bekommst du 24 GB Grafikspeicher. Das sind genauso viele Gigabyte wie beim Mac mini M5 Pro für 1.699 €, der als kompletter Rechner mit Garantie kommt.
Hinzu kommen beim Gebrauchtkauf fehlende Garantie, unklare Vorgeschichte (Mining oder Dauerlast) und ein Netzteil, das die hohe Leistungsaufnahme stemmen muss. Sinnvoll ist die RTX 4090 nur, wenn du ohnehin einen starken Desktop-PC hast, auf CUDA angewiesen bist und ein Angebot deutlich unter dem Marktschnitt findest.
Soll ich auf Qwen 4 oder RTX Spark warten?
Auf Qwen 4 zu warten bringt wenig. Das Modell wird bald erwartet, war Anfang November aber noch nicht erschienen. Wie viel Speicher die neuen Varianten brauchen, ist offen. Die Erfahrung zeigt allerdings: Neue Modellgenerationen erscheinen meist wieder in mehreren Größen, und die Klasse um 27 bis 31 Milliarden Parameter bleibt für Rechner mit 24 bis 36 GB erhalten. Wer heute mit genug Speicherreserve kauft, kann Qwen 4 später einfach nachladen.
Bei RTX Spark ist Warten eher eine Überlegung wert. Nvidias Arm-Chip N1X mit Unified Memory steckt bereits in Notebooks, kompakte Desktop-Rechner sollen in Kürze folgen. Wenn du CUDA-Unterstützung und gemeinsamen Speicher in einem Gerät willst, warte die ersten Preise und Speicherkonfigurationen ab. Brauchst du den Rechner jetzt, kauf lieber heute als auf sinkende Preise zu spekulieren: Wegen der Knappheit bei Speicherchips sind die Preise zuletzt eher gestiegen als gefallen.