KI-Mini-PCs unter 1.300 €: drei Modelle für lokale KI im Vergleich
Die Gewichte von Qwen 3.8-27B belegen als Q4 rund 16 GB. Ob ein Mini-PC das stemmt, hängt deshalb vom Arbeitsspeicher ab und kaum vom Prozessor. Hier siehst du, welcher der drei Rechner unter 1.300 € für welche Modelle reicht und ab wann du besser zur Grafikkarte greifst.
Kurzantwort: unsere Empfehlungen
Weil der Arbeitsspeicher die Modellgröße begrenzt, landet nicht das teuerste Gerät vorn, sondern das mit dem meisten RAM innerhalb des Budgets.
Diese Seite enthält Affiliate-Links. Kaufst du über einen dieser Links, erhalten wir eine kleine Provision. Für dich ändert sich am Preis nichts. Unsere Einschätzung beruht auf Herstellerangaben und öffentlich zugänglichen Fachquellen.
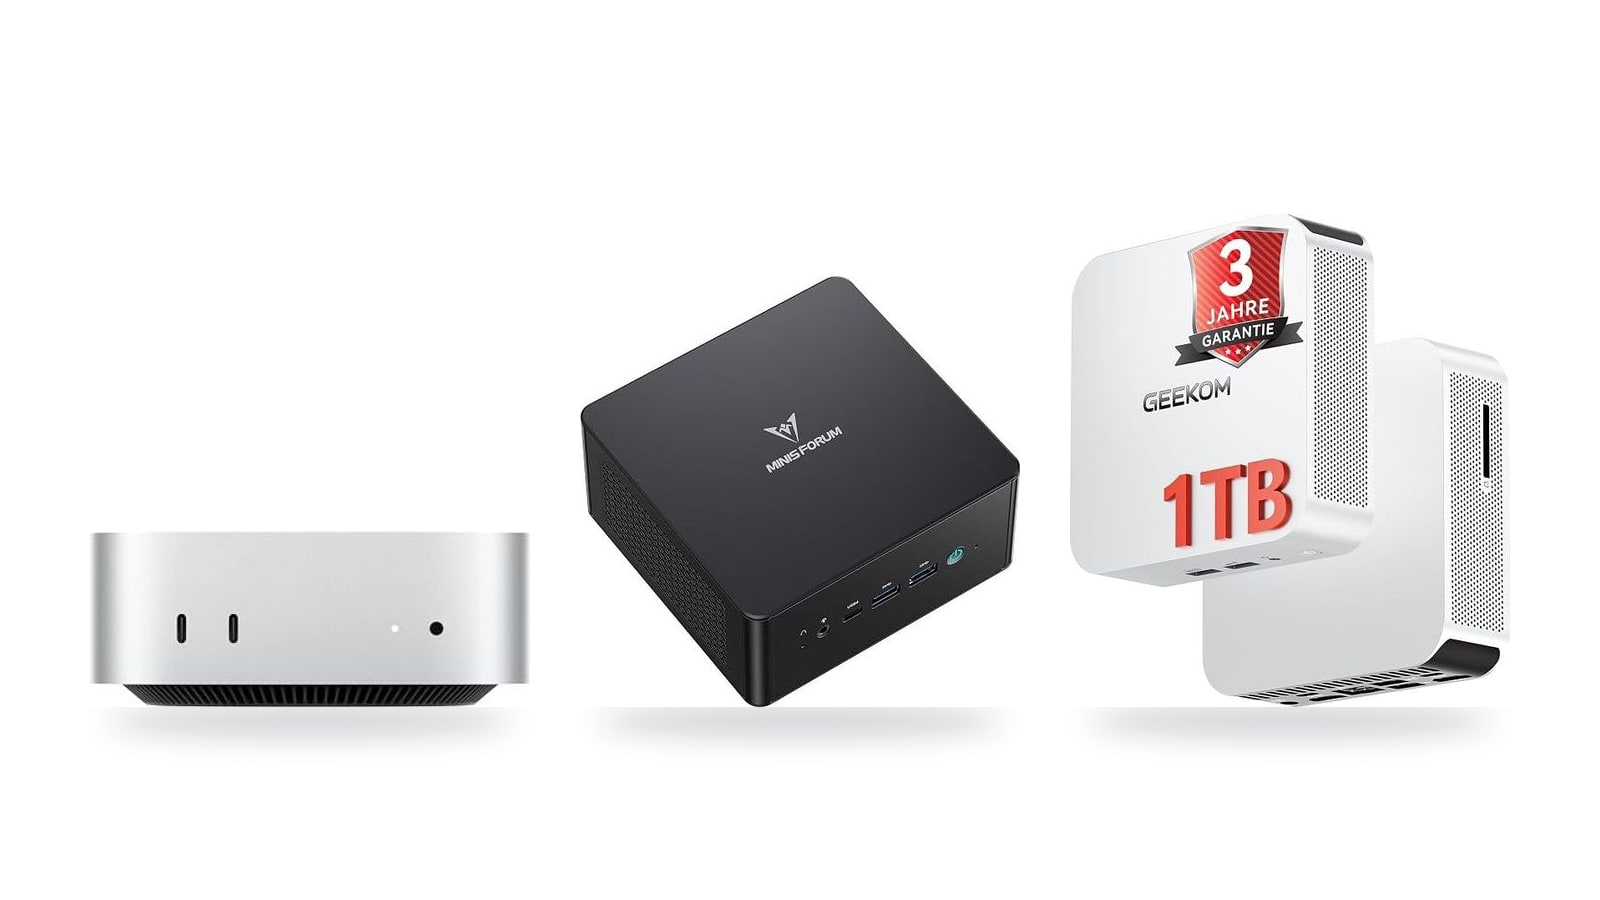
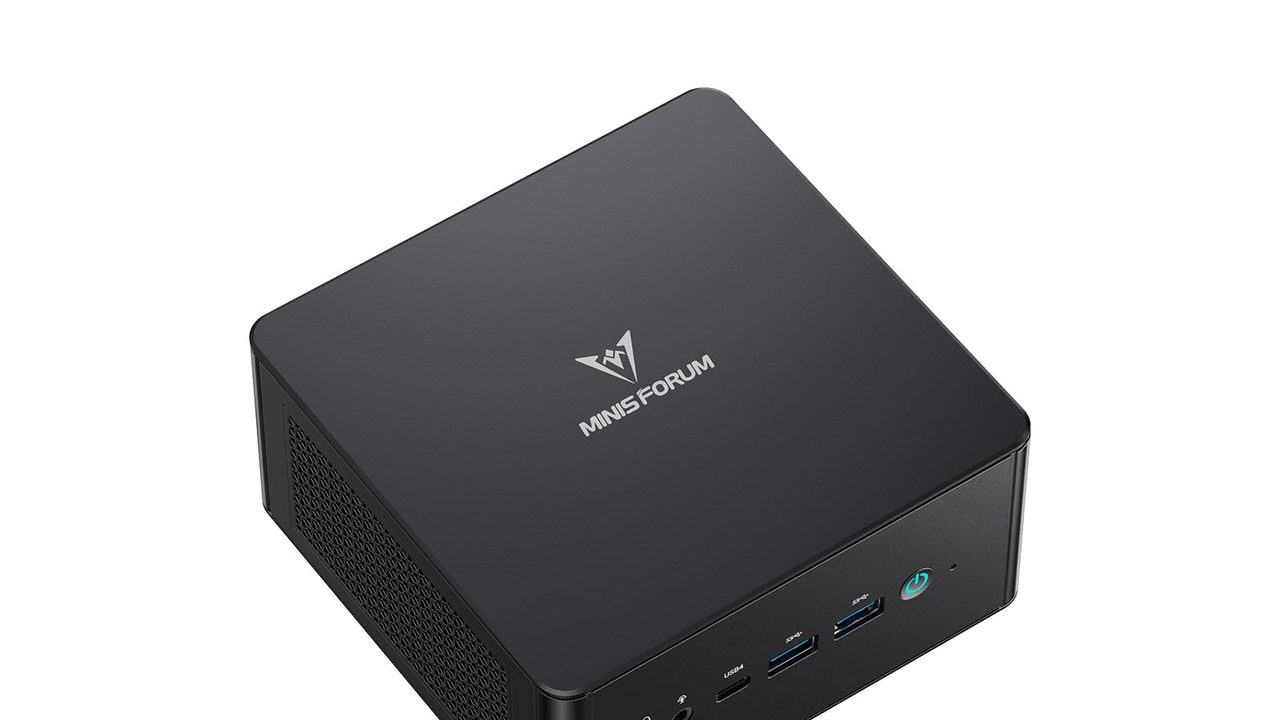
Für 1.159 € bekommst du 32 GB DDR5. Das reicht für Gemma 4 12B mit viel Reserve und knapp auch für Qwen 3.8-27B als Q4-Quantisierung. Dazu kommen 1 TB SSD, und der RAM steckt in SO-DIMM-Steckplätzen, lässt sich also später tauschen.
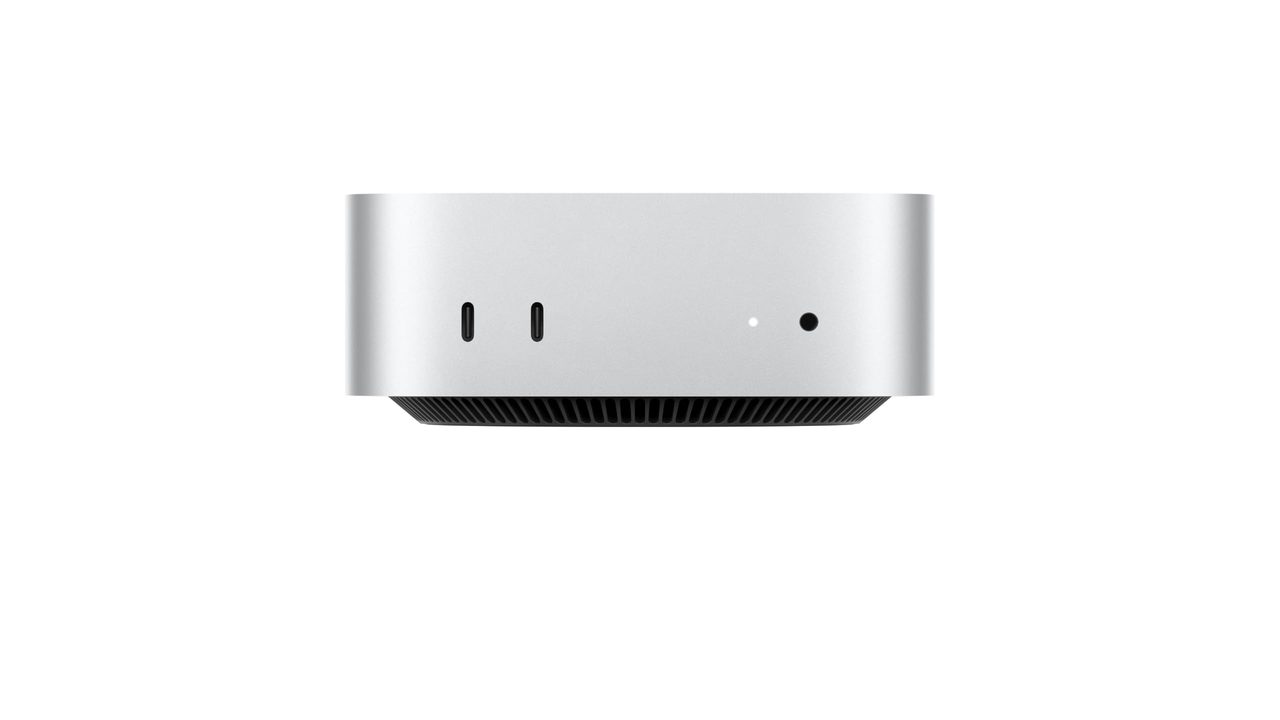
Unified Memory und eine unkomplizierte Einrichtung sind die Stärken. Mit 1.299 € liegt er aber genau an der Budgetgrenze und bietet trotzdem nur 24 GB und 512 GB SSD. Ein 27B-Modell lässt daneben wenig Platz für Kontext und andere Programme, und nachrüsten kannst du nichts.
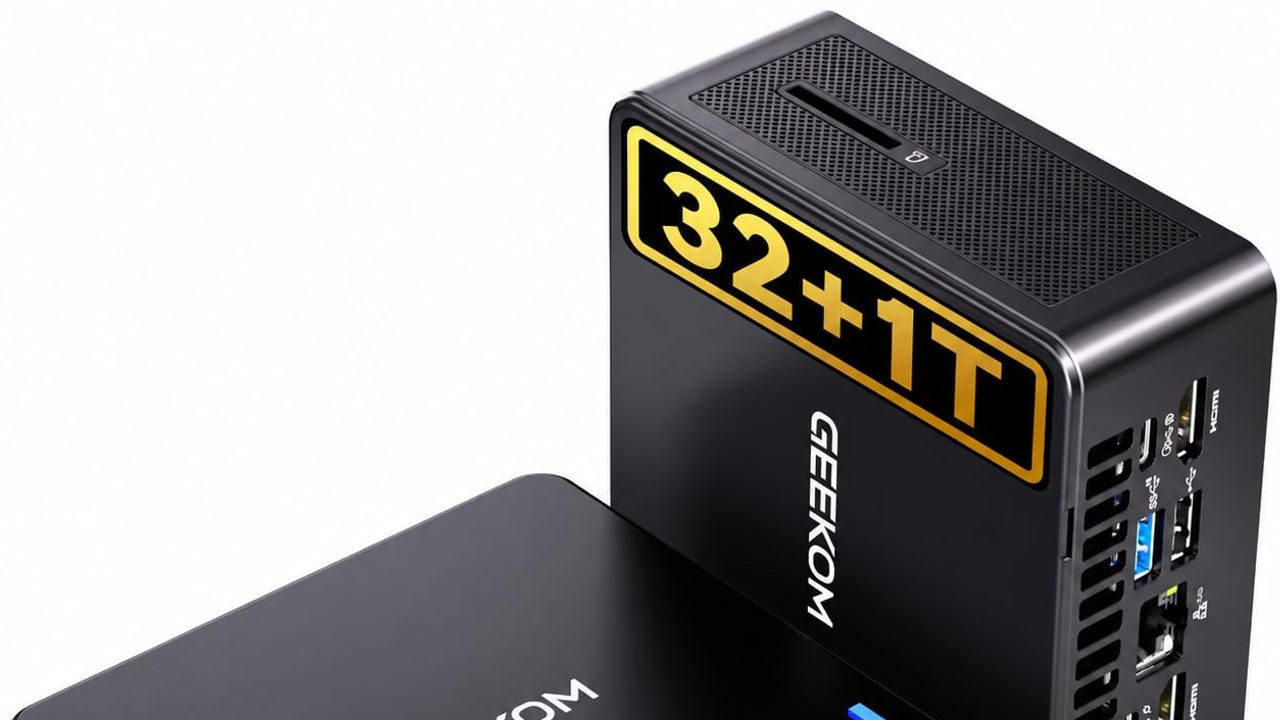
Für 549 € bekommst du einen Ryzen 5 7530U, 16 GB RAM und 1 TB SSD. Das genügt für kleine Modelle wie Gemma 4 E4B mit 128K Kontext und Audio-Eingabe. Bei 12B-Modellen wird es eng, für 27B-Modelle reicht der Arbeitsspeicher nicht.
Der Minisforum UM890 Pro kostet 140 € weniger als der Mac mini und hat trotzdem 8 GB mehr Arbeitsspeicher und doppelt so viel Speicherplatz. Bei lokaler KI ist genau das der Unterschied, ob ein Modell überhaupt startet oder nicht. Der Mac mini lohnt sich vor allem, wenn du ohnehin mit macOS arbeitest und Wert auf eine einfache Einrichtung legst.
Alle Modelle im direkten Vergleich
| Produkt | Bewertung | Preis | Kaufen |
|---|---|---|---|
 Apple Mac mini (M6, 24 GB, 512 GB) 24 GB Unified Memory: Qwen 3.8-27B im 4-Bit-Quant auf dem Schreibtisch +24 GB: 27B-Modelle als 4-Bit-Quant+Neural Accelerator pro GPU-Kern beschleunigt KI -24 GB: wenig Reserve für langen Kontext | 1.299,00 € | Kaufen → | |
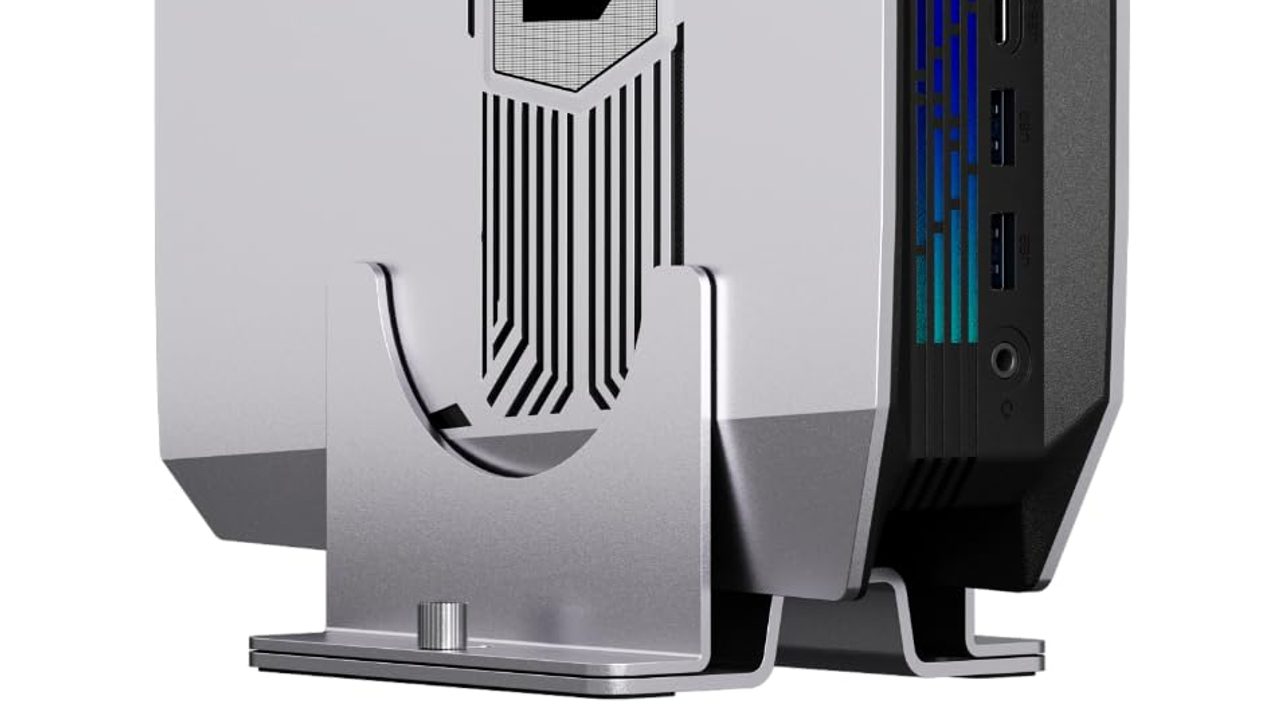
 Minisforum UM890 Pro (32 GB, 1 TB) 32 GB RAM, auf 96 GB aufrüstbar, und Oculink für eine externe Grafikkarte: ein günstiger Einstieg i… +Oculink: externe Grafikkarte für schnellere KI+32 GB fassen 4-Bit-Modelle bis 27B -Radeon 780M: LLMs antworten spürbar langsam | 1.159,00 € | Kaufen → | |
 Geekom A5 Pro Preis-Tipp 15 W TDP und 2,5G LAN: sparsamer Dauerläufer für kleine KI-Agenten +15 W TDP: sparsam im 24/7-Betrieb+2,5G LAN: schneller Zugriff im Heimnetz -16 GB: Qwen 3.8-27B passt nicht | 549,00 € | Kaufen → |
Preise vom 16. Nov. 2026, sie können sich inzwischen geändert haben.
Was mit 32 GB Arbeitsspeicher realistisch läuft
Der Speicher legt fest, welche Modelle starten, die Rechenleistung nur, wie schnell sie antworten. Mit 32 GB im Minisforum UM890 Pro, 24 GB Unified Memory im Mac mini und 16 GB im Geekom A5 Pro ergeben sich drei klar getrennte Klassen.
| Modell | Speicherbedarf | Geekom A5 Pro (16 GB) | Mac mini M6 (24 GB) | UM890 Pro (32 GB) |
|---|---|---|---|---|
| Gemma 4 E4B | klein, für Geräte ohne Grafikkarte gedacht | läuft | läuft | läuft |
| Gemma 4 12B | deutlich weniger als ein 27B-Modell | knapp | läuft | läuft mit viel Reserve |
| Qwen 3.8-27B (UD-Q4KXL) | rund 16 GB nur für die Gewichte | passt nicht | sehr eng | läuft, mit wenig Puffer |
Gemma 4 E4B ist der gemeinsame Nenner. Das Modell bietet 128K Kontext, versteht Text, Bilder und Audio und läuft auf allen drei Geräten. Für Zusammenfassungen, Transkripte oder einen lokalen Assistenten reicht es. Mehr Qualität bringt Gemma 4 12B. Auf dem Mac mini und dem UM890 Pro läuft es entspannt, auf den 16 GB des Geekom bleibt neben dem Betriebssystem dagegen kaum Luft.
Das interessanteste Modell in dieser Klasse ist Qwen 3.8-27B. Es schlägt in mehreren Benchmarks Claude Opus 4.6, das im Februar 2026 noch das führende Cloud-Modell war. Als Unsloth-Quantisierung UD-Q4KXL (etwa 4 Bit) belegen die Gewichte rund 16 GB. Auf 32 GB bleiben dir danach noch etwa 16 GB für Betriebssystem, Browser und den Kontext-Cache. Das funktioniert, ist aber kein großzügiger Puffer. Auf dem Mac mini mit 24 GB teilen sich macOS und Modell rund 8 GB Rest. Für kurze Chats geht das, bei längeren Dokumenten wird es eng.
Starte große Modelle mit 8K bis 16K Token Kontext und erhöhe den Wert schrittweise. Der Kontext-Cache wächst mit jedem zusätzlichen Token. Er ist meist der Grund, warum ein Modell, das eben noch lief, plötzlich abbricht oder auf die SSD auslagert.
Die nativen 262.144 Token Kontext von Qwen 3.8 kannst du auf diesen Geräten vergessen. Wer das Modell per YaRN sogar auf 512K gestreckt hat, nutzte dafür ein MacBook Pro M5 mit 128 GB Unified Memory, also das Vierfache des UM890 Pro.
Auch beim Tempo gibt es eine klare Grenze. Bei integrierter Grafik hängen die Token pro Sekunde vor allem von der Speicherbandbreite ab und weniger von der Zahl der GPU-Kerne. Für jedes erzeugte Token muss das komplette Modell einmal durch den Arbeitsspeicher. Ein 27B-Modell antwortet deshalb spürbar langsamer als Gemma 4 E4B, auch wenn es problemlos in den Speicher passt. Für den Dialog ist das brauchbar, für lange Code-Generierungen dagegen zäh.
Zur Einordnung: Lokale Modelle liegen etwa ein halbes Jahr hinter den Spitzenmodellen aus der Cloud wie Claude Opus 5.5. Wenn dir der Stand der Cloud-Modelle von vor sechs Monaten genügt und Datenschutz wichtiger ist als die letzte Qualitätsstufe, holst du mit 32 GB das Maximum aus diesem Budget heraus.
Kaufkriterien und Einrichtung im Budgetbereich
Neben der reinen RAM-Menge zählen Speichertyp, Aufrüstbarkeit und Anschlüsse. Wer heute 32 GB kauft und später aufrüsten kann, hat mehr Spielraum als jemand mit einem schnelleren Chip und festen 24 GB.
- Schneller DDR5-RAM — Bei integrierter Grafik begrenzt die Speicherbandbreite die Token pro Sekunde. Der Minisforum UM890 Pro nutzt DDR5. Der Geekom A5 Pro mit Ryzen 5 7530U setzt noch auf die ältere DDR4-Plattform.
- Aufrüstbare SO-DIMM-Steckplätze — Beim UM890 Pro tauschst du die Module selbst. Aus 32 GB wird später mehr, ohne dass du ein neues Gerät brauchst.
- NPU ist Nebensache — llama.cpp und LM Studio nutzen den KI-Beschleuniger kaum. Gerechnet wird auf CPU und iGPU, deshalb solltest du für eine NPU keinen Aufpreis zahlen.
- OCuLink oder USB4 — Über diese Anschlüsse kannst du später eine externe Grafikkarte nachrüsten. Der UM890 Pro bietet beides und lässt dir so den Weg zu mehr Grafikspeicher (VRAM) offen.
- Fest verlöteter Speicher — Beim Mac mini (M6, 24 GB) ist der Unified Memory nicht erweiterbar. Die Ausstattung beim Kauf ist also endgültig.
- Genug SSD-Speicherplatz — Schon ein einzelnes 27B-Modell in Q4 belegt zweistellige Gigabyte. 1 TB beim UM890 Pro und beim A5 Pro reicht für eine kleine Modellsammlung, die 512 GB des Mac mini füllen sich schneller.
Für die Gewichtung heißt das: Ein Mini-PC mit NPU-Werbung und 16 GB festem RAM ist für lokale KI die schlechtere Wahl als ein Gerät ohne nennenswerte NPU, aber mit 32 GB in Steckplätzen.
| Kriterium | Warum es zählt | Worauf du achtest |
|---|---|---|
| RAM-Menge | Legt die maximale Modellgröße fest | Mindestens 32 GB für 27B-Modelle |
| RAM-Typ und Bandbreite | Bestimmt die Tok/s bei iGPU-Betrieb | DDR5 statt DDR4 |
| Aufrüstbarkeit | Hält das Gerät länger brauchbar | SO-DIMM statt verlötet |
| Erweiterungsanschlüsse | Ermöglichen eine externe Grafikkarte | OCuLink oder USB4 |
| NPU | Wird von gängiger Software kaum genutzt | Kein Kaufgrund |
In drei Schritten zur lokalen KI
- llama.cpp mit Vulkan-Backend: Auf den AMD-Geräten rechnet das Vulkan-Backend auf der integrierten Radeon-Grafik statt nur auf der CPU. Auf dem Mac mini übernimmt Metal diese Aufgabe automatisch.
- LM Studio als Oberfläche: Wenn du nicht mit der Kommandozeile arbeiten willst, lädst du Modelle in LM Studio per Suche herunter, wählst die Quantisierung und startest den Chat. Unter der Haube arbeitet dabei llama.cpp.
- Docker als Abkürzung: Seit April 2026 liegt Gemma 4 auf Docker Hub. Mit
docker model pull gemma4holst du das Modell, mitdocker model run gemma4startest du es. Das eignet sich gut, wenn Docker ohnehin auf deinem Rechner läuft.
Klein anfangen, dann hochskalieren
Starte mit Gemma 4 E4B, um die Einrichtung zu prüfen. Es läuft auf allen drei Geräten. Erst wenn Tempo und Antworten passen, lädst du ein 27B-Modell wie Qwen 3.8-27B in der Q4-Quantisierung. So erkennst du schnell, ob dein Arbeitsspeicher oder die Bandbreite der Engpass ist.
Wann sich Mac mini oder Grafikkarte mehr lohnen

24 GB Unified Memory: Qwen 3.8-27B im 4-Bit-Quant auf dem Schreibtisch
- 24 GB: 27B-Modelle als 4-Bit-Quant
- Neural Accelerator pro GPU-Kern beschleunigt KI
- Kompaktes Gehäuse passt unter jeden Monitor
- 24 GB: wenig Reserve für langen Kontext
- Maximal 32 GB, kein Upgrade nachträglich

32 GB RAM, auf 96 GB aufrüstbar, und Oculink für eine externe Grafikkarte: ein günstiger Einstieg i…
- Oculink: externe Grafikkarte für schnellere KI
- 32 GB fassen 4-Bit-Modelle bis 27B
- RAM auf 96 GB aufrüstbar
- Radeon 780M: LLMs antworten spürbar langsam
- DDR5-RAM bremst größere Modelle aus

15 W TDP und 2,5G LAN: sparsamer Dauerläufer für kleine KI-Agenten
- 15 W TDP: sparsam im 24/7-Betrieb
- 2,5G LAN: schneller Zugriff im Heimnetz
- RAM auf bis 64 GB nachrüstbar
- 16 GB: Qwen 3.8-27B passt nicht
- Keine dedizierte GPU für Bildgenerierung
Preise vom 16. Nov. 2026, sie können sich inzwischen geändert haben.
Häufig gestellte Fragen
Reichen 16 GB Arbeitsspeicher für lokale KI?
Für den Einstieg ja. Gemma 4 E2B und E4B sind für Geräte mit wenig Arbeitsspeicher gebaut. Sie bieten 128K Kontext und verarbeiten auch Audio, deshalb laufen sie auf dem Geekom A5 Pro mit 16 GB problemlos. Für 27B-Modelle reicht das nicht: Qwen 3.8-27B belegt schon als Q4-Quant rund 16 GB nur für die Gewichte. Dann bleibt nichts für das Betriebssystem und den Kontext übrig. Wer diese Modellklasse nutzen will, braucht mindestens die 32 GB des Minisforum UM890 Pro.
Lohnt es sich, auf Qwen 4 zu warten?
Für die Kaufentscheidung eher nicht. Qwen 4 wird zwar demnächst erwartet, ist aber noch nicht erschienen. Die Anforderungen an die Hardware hängen außerdem von der Modellgröße und der Quantisierung ab, nicht von der Versionsnummer. Ein künftiges Qwen 4 mit 27B Parametern belegt in Q4 ungefähr genauso viel Arbeitsspeicher wie das heutige Qwen 3.8-27B. Mit 32 GB bist du also auch für die nächste Generation dieser Größe gerüstet. Mit 24 GB im Mac mini (M6) bleibt dagegen nur wenig Platz für längeren Kontext.
Kann ich Bilder lokal erzeugen?
Ja, aber rechne nicht mit hohem Tempo. Aktuelle Modelle wie Flux.2, Krea-2 oder Z-Image laufen in ComfyUI als Turbo-Varianten mit FP8- oder BF16-Genauigkeit, damit sie mit wenig Grafikspeicher auskommen. Auf der integrierten Grafik des UM890 Pro oder des Geekom A5 Pro dauert ein einzelnes Bild aber spürbar länger als auf einer Grafikkarte. Zum Ausprobieren und für gelegentliche Motive reicht das. Wenn du regelmäßig viele Bilder erzeugen willst, ist eine Grafikkarte die bessere Wahl. Beim UM890 Pro kannst du eine externe Karte später nachrüsten.
Mac mini oder Minisforum UM890 Pro – welcher passt zu mir?
Für lokale KI spricht mehr für den UM890 Pro: 140 € günstiger, 8 GB mehr Arbeitsspeicher, doppelt so viel SSD und RAM in SO-DIMM-Steckplätzen. Über OCuLink oder USB4 kannst du später sogar eine externe Grafikkarte anschließen. Der Mac mini (M6) lohnt sich, wenn du ohnehin unter macOS arbeitest: Metal läuft ohne Zusatzaufwand, dafür bleibt es dauerhaft bei 24 GB und 512 GB. Den Aufpreis des UM890 Pro gegenüber dem Geekom A5 Pro zahlst du für die 27B-Klasse – wenn dir Gemma 4 E4B genügt, reicht der Geekom.
Neueste Bewertungen
Ratgeber & Artikel