Mini-PC oder Desktop mit RTX 5090? Was sich für lokale LLMs mehr lohnt
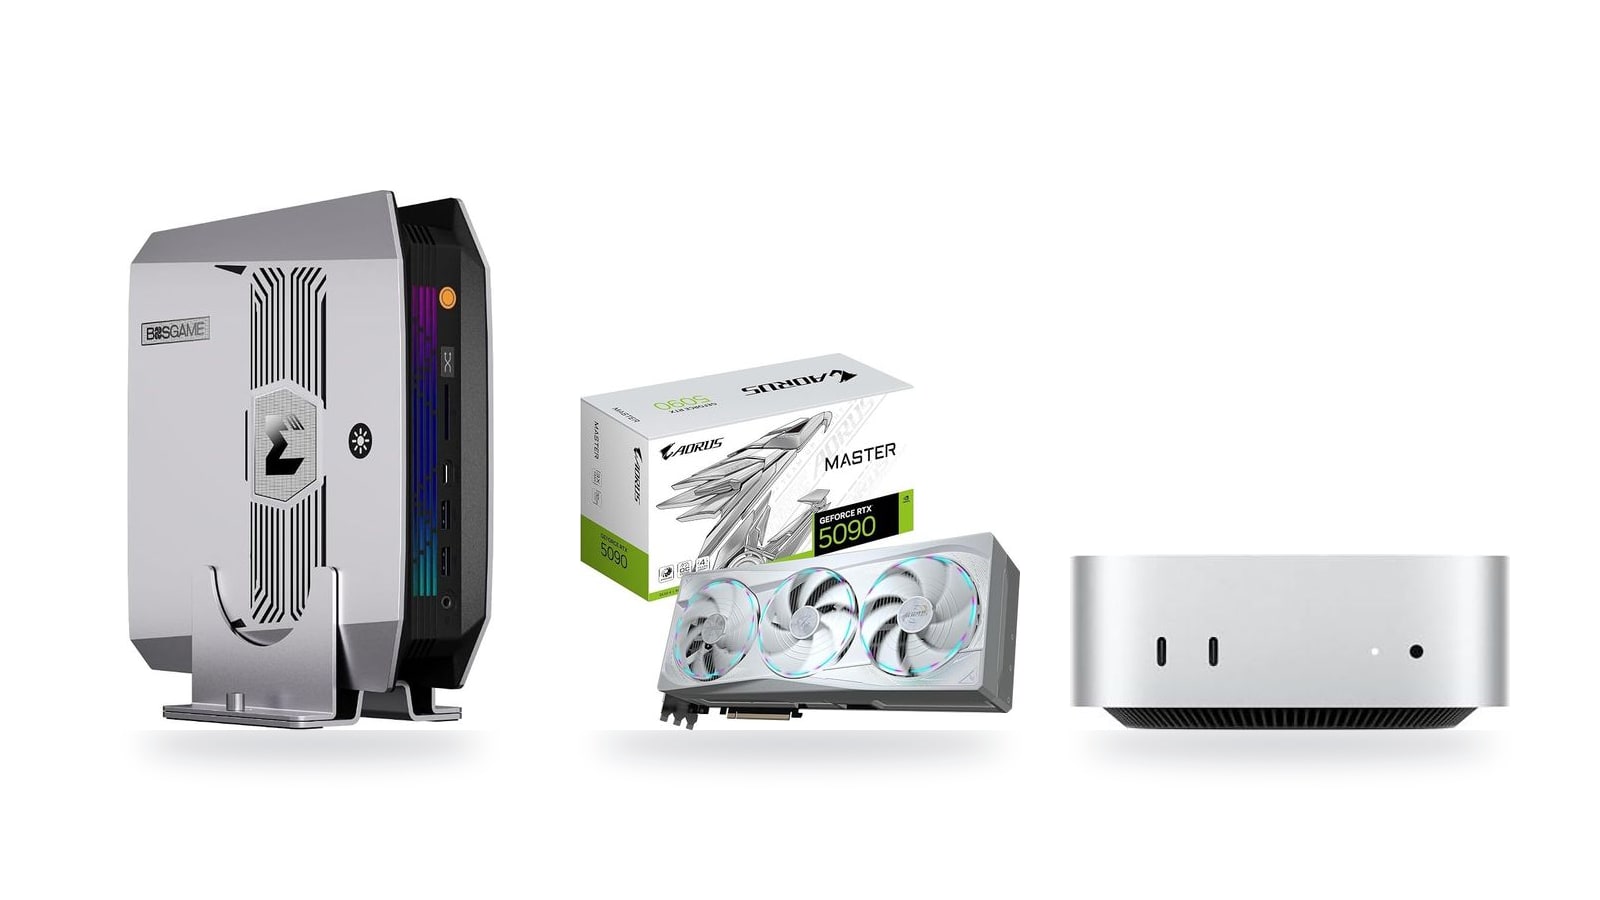
Die RTX 5090 kostet derzeit allein 9.995 Euro, also mehr als zweieinhalbmal so viel wie ein Bosgame M5 mit 128 GB Speicher. Für Qwen 3.8-27B brauchst du keines der beiden Extreme, denn seine Gewichte belegen als 4-Bit-Quant nur rund 16 GB. Entscheidend ist, wie groß deine Modelle werden sollen und wie schnell sie antworten müssen.
Bevor du dich durch Bandbreiten und Benchmarks arbeitest, hier die Kurzfassung. Bei lokalen LLMs entscheidet zuerst der Speicher und erst danach die Rechenleistung. Passt ein Modell nicht in den schnellen Speicher, hilft dir auch die stärkste GPU wenig.
Warum 32 bis 36 GB für die meisten reichen: Quantisierung bedeutet, dass die Modellgewichte auf weniger Bit pro Wert verkleinert werden. Durch diese 4-Bit-Variante schrumpft Qwen 3.8-27B auf etwa 16 GB. Der Rest des Speichers geht an den Kontext, also das „Kurzzeitgedächtnis“ für Chatverlauf und eingelesenen Code, und an das System. Mit 32 GB läuft das entspannt. Ein Gerät wie der Apple Mac Studio (M5 Max, 36 GB) liegt genau in diesem Bereich. Eine RTX 5090 hätte in diesem Szenario noch die Hälfte ihres VRAM frei, also des eigenen Grafikspeichers der Karte. Das ist mehr, als normale Chats je brauchen. Und du hättest fast 10.000 € ausgegeben, nur damit ein 16-GB-Modell schneller antwortet.
Wann die RTX 5090 trotzdem Sinn ergibt: wenn dir Tempo wirklich Geld wert ist, etwa bei täglicher Code-Assistenz mit vielen Anfragen, wenn du auf CUDA angewiesen bist oder wenn Bildgenerierung zu deinen Hauptaufgaben gehört. Dann bekommst du die schnellste Lösung in dieser Auswahl. Rechne aber ehrlich: Zur Karte kommen noch Netzteil, Gehäuse, Mainboard, CPU und RAM.
Wann du eher in die Breite gehen solltest: Willst du große MoE-Modelle laden, dann ist Platz wichtiger als Spitzentempo. MoE steht für „Mixture of Experts“: Solche Modelle sind riesig, rechnen pro Token aber nur mit einem Teil ihrer Gewichte. Das gilt auch, wenn du sehr lange Dokumente oder ganze Codebasen in den Kontext packen willst. Hier spielt Unified Memory seine Stärke aus, also ein gemeinsamer Speicher, den CPU und GPU teilen. Der Bosgame M5 stellt dafür 128 GB bereit, ist in Rohleistung aber langsamer als die 5090. Er ist das Gerät für Leute, die ausprobieren wollen, was überhaupt geht, nicht für Tempo-Junkies.
| Dein Ziel | Speicher, den du brauchst | Sinnvoller Weg |
|---|---|---|
| Chat, Schreiben, Code mit Modellen bis ca. 30B | 32–36 GB schneller Speicher | Mini-PC oder Mac mit genug Unified Memory |
| Maximales Tempo, CUDA, Bildgenerierung | 32 GB VRAM | Desktop mit RTX 5090 |
| Große MoE-Modelle, sehr lange Kontexte | deutlich mehr als 32 GB | Mini-PC mit 128 GB Unified Memory |
Wenn du unsicher bist, fang beim Speicherbedarf deines Wunschmodells an und nicht beim Datenblatt der GPU. Für die meisten, die ein starkes 27B-Modell lokal nutzen wollen, ist die RTX 5090 schlicht überdimensioniert. Das Geld steckst du besser in genug Unified Memory, oder du behältst es.
Ein Gedanke noch zum Gesamtbild: Der Rückstand zur Cloud-Spitze klingt nach viel. Praktisch bedeutet es aber, dass du lokal ungefähr den Stand bekommst, der Anfang 2026 noch als Spitze galt. Das gilt ohne Abo, ohne dass Daten dein Haus verlassen, und auf Hardware, die keinen fünfstelligen Betrag kosten muss.
Meine Empfehlungen nach Einsatzzweck
Neben dem Einsatzzweck schaue ich vor allem auf den Speicher pro Euro, denn er entscheidet, ob ein Modell überhaupt lädt. Ein kurzer Vergleich der Preise je Gigabyte: Der Bosgame M5 kostet rund 29 € pro GB Unified Memory. Beim Mac Studio sind es etwa 72 €, beim Mac mini M6 rund 54 €. Bei der RTX 5090 zahlst du gut 312 € pro GB VRAM, und darin ist der Rest des Rechners noch gar nicht enthalten.

Für alle, die ein aktuelles 27B-Modell als Alltagswerkzeug nutzen wollen, ohne sich um Lüfterlärm oder Netzteile zu kümmern. Qwen 3.8-27B belegt als UD-Q4KXL-Quant rund 16 GB, damit bleibt bei 36 GB genug Platz für Kontext und System.
Der Mac Studio ist für mich der vernünftigste Kauf, weil er genau die Modellklasse abdeckt, die gerade am interessantesten ist: 27B-Modelle, die mit dem Cloud-Stand von Anfang 2026 mithalten. Mit 2.599 € kostet der komplette Rechner gut ein Viertel dessen, was du allein für eine RTX 5090 ausgibst. Die Einschränkung: Für 70B-Modelle oder große MoE-Modelle reichen 36 GB nicht. Wer dahin will, ist beim nächsten Tipp besser aufgehoben.

Für Experimentierfreudige, die große MoE-Modelle oder sehr lange Kontexte laden wollen. 128 GB Unified Memory für 3.699 € sind der meiste Speicher pro Euro im ganzen Katalog.
In 128 GB passen Gemma 4 31B und das MoE-Modell 26B A4B gleichzeitig, und es bleibt trotzdem Reserve. Weil MoE-Modelle pro Token nur einen Teil ihrer Gewichte lesen, laufen sie trotz der mäßigen Speicherbandbreite des Chips flüssiger als gleich große dichte Modelle. Ehrlich gesagt: Der Ryzen AI Max+ 395 ist nicht mehr die neueste Generation, sein Nachfolger ist bereits erschienen. Der Preisvorteil gegenüber den neuen Geräten ist aber so groß, dass der M5 für mich weiterhin die Empfehlung in dieser Klasse bleibt.

Nur für dich, wenn Geschwindigkeit wirklich dein Engpass ist, etwa bei täglicher Code-Assistenz oder lokaler Bildgenerierung mit Flux.2 oder Z-Image in ComfyUI. Für reines Chatten mit einem 27B-Modell ist sie deutlich zu groß dimensioniert.
Die 5090 bringt das CUDA-Ökosystem mit, das die meisten Tools ohne Umwege unterstützt, und mit 32 GB VRAM den schnellsten Speicher dieser Auswahl. Mehr als 32 GB gibt es aber nicht, und der Preis von 9.995 € gilt nur für die Karte. Das ist eine Investition für Leute, die mit dem Rechner Geld verdienen, und kein Spielzeug für einen Abend.

Für Apple-Nutzer, die lokale KI ausprobieren wollen, ohne gleich ein Studio-Budget auszugeben. Kleine Modelle wie Gemma 4 E4B oder 12B laufen auf 24 GB problemlos.

Für alle, die mit 549 € herausfinden wollen, ob lokale Modelle überhaupt in ihren Alltag passen. Gemma 4 E4B ist genau für solche sparsamen Geräte gedacht, und auch 12B ist für einfache Aufgaben machbar.
Beide Einstiegsgeräte haben eine klare Grenze: Für Qwen 3.8-27B sind sie nicht gemacht. Beim Mac mini M6 gibt macOS der GPU nur einen Teil der 24 GB frei, und 16 GB Modellgewichte plus Kontext werden dann eng. Beim Geekom rechnet ein x86-Prozessor ohne dedizierte GPU, deshalb ist dort bei Modellgröße und Tempo früher Schluss. Für Zusammenfassungen, Übersetzungen oder einen lokalen Assistenten mit Gemma 4 genügt das aber. Auf beiden Geräten verarbeiten Gemma 4 E4B und 12B obendrein auch Audio.
Du weißt schon, welches Modell du nutzen willst? Dann rechne die Gewichte in GB aus, schlag etwa ein Drittel für den Kontext drauf und nimm das günstigste Gerät, in das beides passt. Für ein 27B-Modell landest du damit beim Mac Studio, für alles darüber beim Bosgame M5. Die 5090 kommt erst ins Spiel, wenn dir die Geschwindigkeit nicht reicht. Am Speicherplatz liegt es bei ihr fast nie.
Speicher statt Rechenleistung: so rechnest du richtig
Bei lokalen Sprachmodellen fragen viele zuerst nach TFLOPS und Shader-Einheiten. Für die Kaufentscheidung ist das die falsche Reihenfolge. Zuerst zählt, ob das Modell überhaupt in den Speicher passt. Danach zählt, wie schnell dieser Speicher Daten liefert. Die reine Rechenleistung kommt erst an dritter Stelle, weil bei der Textgenerierung fast immer der Speicher bremst und nicht der Chip.
Schritt 1: Wie groß ist das Modell?
Die Größe eines Modells wird in Parametern angegeben. Das sind die gelernten Zahlenwerte, aus denen das Modell besteht. Im Originalformat belegt jeder Wert 16 Bit. Bei der 4-Bit-Quantisierung werden die Gewichte auf etwa 4 Bit pro Wert verkleinert. Das kostet etwas Genauigkeit, viertelt aber ungefähr den Platzbedarf.
Meine Faustregel: Bei 4 Bit brauchst du rund 0,5 bis 0,6 GB pro Milliarde Parameter. Für Qwen 3.8-27B sieht die Rechnung so aus:
- 27 Milliarden × 0,5 GB = 13,5 GB
- 27 Milliarden × 0,6 GB = 16,2 GB
- Die verbreitete Variante UD-Q4KXL liegt mit rund 16 GB am oberen Ende.
Dazu kommt der Kontext, also alles, was das Modell gerade im Blick behalten muss: deine Frage, den bisherigen Chatverlauf und eingefügten Code. Dieser Zwischenspeicher heißt KV-Cache und wächst mit jedem Token. Ein Token entspricht grob einer Silbe oder einem kurzen Wort. Bei kurzen Chats sind das wenige Gigabyte. Bei sehr langen Kontexten kann der KV-Cache größer werden als das Modell selbst. Plane deshalb immer Luft über der reinen Modellgröße ein.
| Modellgröße | Gewichte bei 4 Bit (ca.) | Passt in 32 GB VRAM? | Passt in 128 GB Unified Memory? |
|---|---|---|---|
| 12B (z. B. Gemma 4 12B) | 6–7 GB | ja, mit viel Platz für Kontext | ja |
| 27B (Qwen 3.8-27B) | 14–16 GB | ja | ja |
| 31B (Gemma 4 31B) | 16–19 GB | ja, bei langem Kontext wird es eng | ja |
| 70B-Klasse | 35–42 GB | nein | ja |
| 120B-Klasse | 60–72 GB | nein | ja |
Schritt 2: Wie schnell ist der Speicher?
Ein dichtes Modell muss für jedes erzeugte Token im Kern alle Gewichte einmal aus dem Speicher lesen. Die Speicherbandbreite, also die Datenmenge pro Sekunde zwischen Speicher und Chip, setzt deshalb die Obergrenze für die Tokens pro Sekunde. Eine grobe Rechnung: Bandbreite geteilt durch Modellgröße ergibt das theoretische Maximum. In der Praxis landest du spürbar darunter. Als Vergleich zwischen zwei Geräten taugt die Rechnung aber gut.
- 32 GB VRAMeigener Grafikspeicher der RTX 5090, reicht für Modelle bis etwa 30B samt Kontext
- ca. 1,8 TB/sSpeicherbandbreite der RTX 5090, bei 16 GB Modellgröße rechnerisch über 100 Tokens/s als Obergrenze
- 128 GB Unified Memorygemeinsamer Speicher für CPU und GPU im Bosgame M5, genug Platz auch für 70B- und 120B-Modelle
- ca. 256 GB/sBandbreite des Ryzen AI Max+ 395, bei 16 GB Modellgröße rechnerisch nur rund 16 Tokens/s als Obergrenze
An diesen Zahlen sieht man den Zielkonflikt. Die RTX 5090 hat rund siebenmal so viel Bandbreite wie der Bosgame M5 und antwortet entsprechend flotter. Dafür bietet der Bosgame viermal so viel Speicher. Auf dem Mini-PC laufen also Modelle, die auf der Grafikkarte gar nicht starten, allerdings im gemächlichen Lesetempo. Bei Qwen 3.8-27B kannst du der Antwort auf dem Bosgame noch bequem beim Entstehen zusehen. Bei einem 70B-Modell wird daraus eher Geduldsarbeit.
Etwas entschärft wird das bei MoE-Modellen. MoE steht für „Mixture of Experts“. Solche Modelle aktivieren pro Token nur einen kleinen Teil ihrer Gewichte. Ein Modell wie Gemma 4 26B A4B liest pro Token nur etwa 4 Milliarden aktive Parameter und läuft deshalb auch bei mäßiger Bandbreite deutlich schneller, als die Gesamtgröße vermuten lässt. Ganz in den Speicher passen muss es trotzdem.
Schritt 3: Was passiert, wenn es nicht passt?
Ist das Modell größer als der VRAM, lagern Programme wie llama.cpp einen Teil der Schichten in den normalen Arbeitsspeicher aus. Diese Daten müssen dann über den PCIe-Bus und den deutlich langsameren System-RAM laufen. Das Tempo bricht dabei nicht um ein paar Prozent ein, sondern oft um ein Vielfaches. Eine 5090, die ein 70B-Modell nur zur Hälfte fasst, ist dann nicht mehr schneller als ein Mini-PC mit genug Unified Memory, kostet aber ein Mehrfaches.
Meine Reihenfolge beim Rechnen
- Passt das Modell plus Kontext komplett in den Speicher? Wenn nein, ist das Gerät für dieses Modell raus, egal wie stark der Chip ist.
- Reicht die Bandbreite für dein Wunschtempo? Teile die Bandbreite durch die Modellgröße, dann hast du die grobe Obergrenze.
- Erst danach: Rechenleistung, CUDA-Unterstützung, Lautstärke und Preis.
Für Modelle der 27B-Klasse heißt das: Ab etwa 32 GB nutzbarem Speicher bist du auf der sicheren Seite. Mehr Speicher brauchst du erst, wenn du größere Modelle oder sehr lange Kontexte laden willst.
Desktop mit RTX 5090: Tempo mit hohem Eintrittspreis
Bevor es um Leistung geht, kurz zum Elefanten im Raum: Grafikkarten, die für KI taugen, sind absurd teuer geworden. Laut heise kostet eine vier Jahre alte RTX 4090 gebraucht auf Kleinanzeigen rund 4.000 € und neu bis zu 5.000 €. Zur Einordnung: Zum Marktstart lag ihre UVP bei 1.769 €. Die Nvidia GeForce RTX 5090 steht aktuell bei 9.995 €, und zwar nur für die Karte. Mainboard, CPU, ein kräftiges Netzteil, Gehäuse und Arbeitsspeicher kommen noch dazu.
Für dieses Geld bekommst du auch einen Bosgame M5 mit 128 GB Unified Memory plus einen Apple Mac Studio (M5 Max, 36 GB) und behältst noch rund 3.700 € übrig. Die 5090 muss ihren Preis also mit etwas rechtfertigen, das die anderen Geräte nicht können.
Wo die 5090 ihr Geld wert ist
Der stärkste Grund ist nicht die rohe Rechenleistung, sondern das CUDA-Ökosystem. CUDA ist Nvidias Programmierschnittstelle für Berechnungen auf der Grafikkarte. Fast jedes KI-Werkzeug wird zuerst dafür gebaut und optimiert. Das zeigt sich auch in Zahlen: igorslab hat in llama.cpp mit Gemma 4 E4B gemessen, dass das CUDA-Backend schneller arbeitet als Vulkan, die herstellerunabhängige Alternative. Wer AMD- oder Intel-Grafik nutzt, landet oft genau bei Vulkan.
Noch deutlicher wird der Vorteil bei der Bildgenerierung. Aktuelle Modelle wie Flux.2, Krea-2 und Z-Image laufen auf einer Nvidia-Karte in ComfyUI ohne Umwege. Laut PCGH greift man bei knappem VRAM auf Turbo-Versionen mit FP8- oder BF16-Genauigkeit zurück. Mit 32 GB brauchst du diese Kompromisse deutlich seltener. Bei Text-LLMs bleiben neben den rund 16 GB von Qwen 3.8-27B noch etwa 16 GB für Kontext und Zwischenspeicher frei. Das ist komfortabel für lange Code-Sitzungen.
Wo sie an eine harte Wand fährt
Bei 32 GB ist Schluss. Alles, was nicht mehr in den VRAM passt, lagert llama.cpp in den normalen Arbeitsspeicher aus. Der ist über PCIe angebunden und um ein Vielfaches langsamer. Ein großes MoE-Modell mit 60 oder 100 GB Gewichten läuft dann zwar technisch, aber das Tempo bricht massiv ein. Genau der Grund, warum du die Karte gekauft hast, ist dann weg. Für solche Modelle ist ein Gerät mit viel Unified Memory schlicht das passendere Werkzeug, auch wenn es langsamer rechnet.
Die vernünftigere Desktop-Variante
Laut heise erledigt schon eine Grafikkarte für rund 920 € in einem normalen Gaming-PC sinnvolle KI-Arbeit, Coding-Assistenz eingeschlossen. Das kostet weniger als ein Zehntel der 5090. Weil die meisten aktuellen Mini-ITX-Gehäuse Grafikkarten mit voller Länge und 2 bis 3 Slots aufnehmen, muss der Rechner dafür nicht einmal groß sein. Hast du schon einen Gaming-PC, ist das fast immer der klügere erste Schritt.
Vorteile
- Höchstes Tempo, solange das Modell komplett in die 32 GB VRAM passt
- Ausgereiftes CUDA-Ökosystem: in llama.cpp laut igorslab schneller als Vulkan
- Bildmodelle wie Flux.2, Krea-2 und Z-Image laufen in ComfyUI ohne Umwege
- Qwen 3.8-27B (rund 16 GB) passt mit viel Reserve für langen Kontext
- Karte lässt sich auch in einem kompakten Mini-ITX-Gehäuse unterbringen
Nachteile
- 9.995 € allein für die Grafikkarte, der restliche PC kommt noch obendrauf
- Harte Grenze bei 32 GB: Größere Modelle weichen in den langsamen Arbeitsspeicher aus
- Für große MoE-Modelle ist ein Unified-Memory-Gerät die passendere Wahl
- Laut heise deckt schon eine Karte für rund 920 € viele KI-Aufgaben ab
Mein ehrliches Fazit zu diesem Weg: Die RTX 5090 ist kein schlechter Kauf, aber ein sehr spezieller. Sie lohnt sich, wenn du täglich mit Code-Assistenz arbeitest, regelmäßig Bilder generierst und deine Modelle in 32 GB passen. Willst du nur ausprobieren, was lokale LLMs können, zahlst du hier vor allem für Leistungsreserven, die du nie abrufst.
Mini-PC mit Unified Memory: mehr Platz für große Modelle
Bei lokalen LLMs gibt es im Kern drei Wege: eine Desktop-Grafikkarte mit eigenem VRAM, einen x86-Mini-PC mit Unified Memory und einen Mac. Weil CPU und GPU sich beim Unified Memory einen Speicherpool teilen, passt in einen kleinen Rechner plötzlich ein Modell, für das du sonst mehrere Grafikkarten bräuchtest. Der Preis dafür ist Tempo.
| Kriterium | Desktop mit RTX 5090 | x86-Mini-PC: Bosgame M5 | Mac Studio (M5 Max, 36 GB) |
|---|---|---|---|
| Speicher für Modelle | 32 GB VRAM, danach geht es in den langsamen Arbeitsspeicher | 128 GB Unified Memory, ein großer Teil davon für die GPU nutzbar | 36 GB Unified Memory, macOS reserviert einen Teil für das System |
| Passende Modellgröße | bis etwa 30B in 4 Bit, mit Luft für Kontext | große MoE-Modelle und sehr lange Kontexte | 27B-Modelle wie Qwen 3.8-27B mit normalem Kontext |
| Stärke | höchstes Tempo, CUDA, Bildgenerierung | viel Platz pro Euro | leise, sparsam, kompakt |
| Schwäche | Kartenpreis, Stromverbrauch, harte 32-GB-Grenze | deutlich langsamer als die 5090, kein CUDA | kaum Reserve, mehr Speicher wird schnell teuer |
| Für wen | Leute mit täglicher Code-Assistenz oder Bild-Workflows | Experimentierer mit großen Modellen | Apple-Nutzer, die ein ruhiges Komplettgerät wollen |
Bosgame M5: die ältere Plattform ist hier der Vorteil
Der Bosgame M5 setzt noch auf den Ryzen AI Max+ 395 (Strix Halo). Den Nachfolger gibt es schon: Der Ryzen AI Max+ PRO 495 („Gorgon Halo") bringt bis zu 192 GB Unified Memory mit. Ein Mini-PC mit diesem Chip kostet laut TechRadar aber ab 5.299 £, also deutlich mehr als der Bosgame M5 mit 128 GB und 2 TB für 3.699 €.
Mit der Faustregel von oben (0,5 bis 0,6 GB pro Milliarde Parameter bei 4 Bit) passen in 128 GB Modelle mit 60 bis 90 GB Gewichten, und es bleibt noch Platz für Kontext und System. Damit hast du Spielraum für die großen MoE-Modelle, die auf der RTX 5090 gar nicht erst vollständig in den VRAM passen. Wenn du viel Speicher brauchst, ist der 395 derzeit die vernünftigere Wahl. Den Aufpreis für die 64 GB mehr beim 495 zahlst du nur sinnvoll, wenn dein Wunschmodell nachweislich nicht in 128 GB passt.
Mac Studio: genau passend, aber nicht mehr
Der Apple Mac Studio (M5 Max, 36 GB) für 2.599 € ist für 27B-Modelle ein stimmiges Paket. Er ist leise, braucht wenig Strom und steht unauffällig auf dem Schreibtisch. Neben den rund 16 GB von Qwen 3.8-27B bleibt in 36 GB genug für Kontext und macOS. Für größere Modelle ist diese Konfiguration aber nicht gedacht. Nach Herstellerangabe geht der Mac Studio zwar bis 512 GB, und mehrere Macs lassen sich per Thunderbolt 5 RDMA zu einem Cluster koppeln. Beides spielt preislich aber in einer anderen Liga als die hier verlinkte Konfiguration.
Lange Kontexte brauchen mehr Speicher, als du denkst
Die Modellgröße ist nur die halbe Rechnung. Jedes Token im Kontext belegt Platz im KV-Cache, also dem Zwischenspeicher, in dem das Modell sich den bisherigen Text merkt. Je länger der Kontext, desto größer wird dieser Cache. Ein gut dokumentiertes Beispiel: Laut einem Erfahrungsbericht auf dev.to wurde Qwen 3.8-27B auf einem MacBook Pro M5 mit 128 GB per YaRN (einem Verfahren, das das Kontextfenster über die trainierte Länge hinaus streckt) von nativ 262.144 auf 512K Tokens erweitert. Das Modell selbst ist dabei dasselbe 16-GB-Modell geblieben, den Speicher hat der Kontext gefressen. Wenn du ganze Codebasen oder lange Dokumente auf einmal einlesen willst, ist Unified Memory deshalb oft wichtiger als rohe Rechenleistung.
Klassische Mini-PCs sind keine Abkürzung
Der Minisforum UM890 Pro und der GEEKOM IT15 haben jeweils 32 GB Arbeitsspeicher. Die integrierte Grafik darf davon nur einen Teil nutzen, und die Speicheranbindung ist nicht auf KI ausgelegt. Einen großen gemeinsamen Speicherpool wie beim Bosgame M5 oder beim Mac haben sie also nicht. Für kleine Modelle wie Gemma 4 E4B, für Zusammenfassungen oder einfache Chat-Aufgaben reichen sie. Ein 27B-Modell mit brauchbarem Tempo darfst du von ihnen aber nicht erwarten. Das gilt erst recht für den Geekom A5 Pro für 549 €.
Unterm Strich: Die Desktop-GPU kauft Tempo, der Mini-PC mit Unified Memory kauft Platz, der Mac kauft Ruhe. Überleg dir zuerst, welches Modell mit welcher Kontextlänge du wirklich nutzen willst. Erst danach lohnt der Blick auf den Preis.
Für wen sich welcher Weg lohnt
Die Hardware-Frage ist eigentlich eine Frage nach deinem Alltag: Wie oft nutzt du ein lokales Modell, welches Modell, und wofür? Je nachdem landest du bei einem der Wege unten. Manchmal heißt die beste Antwort aber: gar nicht groß aufrüsten.
Desktop mit RTX 5090: für Vielnutzer mit Tower-PC. Die Karte lohnt sich, wenn du täglich mit Code-Assistenz arbeitest, also das Modell stundenlang Vorschläge im Editor liefert. Dann merkst du jede Sekunde Wartezeit. Dazu kommt Bildgenerierung. Modelle wie Flux.2 oder Z-Image laufen in ComfyUI am besten mit CUDA. Sinnvoll ist das nur, wenn du ohnehin einen Tower-PC betreibst mit passendem Netzteil und Platz im Gehäuse. Sonst kommt zu den 9.995 € für die Karte noch ein ganzer Rechner dazu. Eine Grenze bleibt: Was nicht in die 32 GB VRAM passt, wird deutlich langsamer.
Mac mini oder Mac Studio: für Apple-Nutzer, die Ruhe wollen. Wenn du schon im Apple-Ökosystem lebst und einen leisen Rechner ohne Bastelaufwand willst, ist der Apple Mac mini (M6, 24 GB, 512 GB) für 1.299 € der günstigste sinnvolle Einstieg. Der Apple Mac mini (M5 Pro, 24 GB, 512 GB) für 1.699 € bringt den stärkeren Chip, aber kein Gigabyte mehr Speicher. Achtung beim Preis: Der Mac mini startet zwar bei 1.049 €, aber diese Basisversion ist für LLMs zu klein. Brauchbar wird es erst ab 24 GB. Und auch die werden mit Qwen 3.8-27B (rund 16 GB Gewichte) eng, sobald der Kontext wächst. Wer 27B-Modelle ernsthaft nutzen will, greift zum Apple Mac Studio (M5 Max, 36 GB) für 2.599 € und hat damit spürbar mehr Luft.
Bosgame M5: für Experimentierer mit Geduld. Der Bosgame M5 (Ryzen AI Max+ 395, 128 GB, 2 TB) für 3.699 € ist die Kiste für Leute, die große MoE-Modelle ausprobieren wollen. In 128 GB passt viermal so viel wie in die 32 GB einer RTX 5090. Der Preis dafür ist Tempo: Mit rund 256 GB/s Speicherbandbreite liefert er nur etwa ein Siebtel dessen, was die 5090 schafft. Für Neugier und Ausprobieren passt das. Wer im Arbeitsalltag flüssig Code generieren will, wird damit eher nicht glücklich.
Gut für
- Entwickler, die täglich lokale Code-Assistenz nutzen und schon einen Tower-PC haben: Desktop mit Nvidia GeForce RTX 5090
- Wer neben Text auch Bilder mit Flux.2 oder Z-Image erzeugt und auf CUDA angewiesen ist: RTX 5090
- Mac-Nutzer, die ein 27B-Modell leise und ohne Treiberstress betreiben wollen: Apple Mac Studio (M5 Max, 36 GB), für kleinere Modelle und kleineres Budget der Apple Mac mini (M6, 24 GB, 512 GB)
- Tüftler, die große MoE-Modelle laden und Tempo gegen Speicherplatz tauschen: Bosgame M5 (Ryzen AI Max+ 395, 128 GB, 2 TB)
Nicht für
- Wer nur Gemma 4 E4B oder 12B nutzt: Dafür sind 2.599 € oder gar 9.995 € reine Überdimensionierung
- Wer gelegentlich chattet und Spitzenqualität erwartet: Die Cloud bleibt vorn
- Wer keinen Tower-PC hat und nur für eine Grafikkarte einen kompletten Rechner neu kaufen müsste
- Wer mit dem Basis-Mac-mini für 1.049 € liebäugelt, um darauf LLMs zu betreiben
Lass es lieber, wenn dir kleine Modelle reichen. Das ist der Teil, den Händler ungern hören. Gemma 4 E4B ist laut Google ausdrücklich für sparsame Geräte gedacht. Das 12B-Modell braucht bei 4 Bit grob 7 GB plus etwas Platz für den Kontext. Dafür reicht ein Geekom A5 Pro für 549 € oder ein Minisforum UM890 Pro (32 GB, 1 TB) für 1.159 €. Der Minisforum hat mit seinen 32 GB noch Reserven für längere Gespräche oder ein zweites Modell nebenbei.
Und für echte Spitzenleistung bleibt die Cloud vorn. Lokale Modelle liegen laut heise etwa ein halbes Jahr hinter Angeboten wie Claude Opus 5.5. Wenn du nur ab und zu ein schwieriges Problem lösen willst, holst du die 9.995 € für eine RTX 5090 über ein Cloud-Abo sehr lange nicht wieder rein. Lokale Hardware lohnt sich vor allem, wenn du viel, regelmäßig oder mit Daten arbeitest, die das Haus nicht verlassen sollen. Fehlt alles drei, ist die günstigste Lösung meist auch die vernünftigste.
Alle Kandidaten im Preisvergleich
| Produkt | Bewertung | Preis | Kaufen |
|---|---|---|---|
 Nvidia GeForce RTX 5090 32 GB GDDR7 an 512 Bit: 27B-Modelle wie Qwen 3.8 laufen komplett im VRAM +32 GB VRAM: 27B-Modelle samt Kontext+512 Bit: zügigere Token-Ausgabe -Preis weit über der RX 9070 XT | 9.995,00 € | Kaufen → | |
 Apple Mac Studio (M5 Max, 36 GB) 36 GB Unified Memory für 27B-Modelle wie Qwen 3.8 – leise auf dem Schreibtisch +36 GB: Qwen 3.8-27B passt komplett+Neural Accelerator je GPU-Kern -36 GB verlötet, später nicht aufrüstbar | 2.599,00 € | Kaufen → | |
 Bosgame M5 (Ryzen AI Max+ 395, 128 GB, 2 TB) 128 GB Unified Memory im Mini-PC: Platz für große lokale LLMs +128 GB Unified Memory für große LLMs+Radeon 8060S: Bildgenerierung ohne Grafikkarte -RAM verlötet, später nicht aufrüstbar | 3.699,00 € | Kaufen → | |
 Apple Mac mini (M5 Pro, 24 GB, 512 GB) Top-Empfehlung 24 GB Unified Memory und 307 GB/s: lokale 27B-Modelle in einem 12,7-cm-Würfel +24 GB: 27B-Modelle als 4-Bit-Quant+307 GB/s: zügigere Token-Ausgabe -24 GB: wenig Puffer für Langkontext | 1.699,00 € | Kaufen → | |
| Apple Mac mini (M6, 24 GB, 512 GB) 24 GB Unified Memory: Qwen 3.8-27B im 4-Bit-Quant auf dem Schreibtisch +24 GB: 27B-Modelle als 4-Bit-Quant+Neural Accelerator pro GPU-Kern beschleunigt KI -24 GB: wenig Reserve für langen Kontext | 1.299,00 € | Kaufen → | |
 GEEKOM IT15 (Core Ultra 9 285H, 32 GB, 1 TB) Core Ultra 9 285H und 32 GB DDR5: kompakter Einstieg für kleine lokale KI-Modelle +Zwei SODIMM-Slots: RAM später aufrüstbar+Zweiter M.2-Slot für Modellbibliothek -Keine eigene GPU: größere LLMs laufen zäh | 1.399,00 € | Kaufen → |
Preise vom 16. Nov. 2026, sie können sich inzwischen geändert haben.
Was du vor dem Kauf noch wissen solltest
Bevor du bestellst, bleiben meist noch ein paar Fragen offen. Die vier häufigsten beantworte ich hier kurz. Bei allen gilt dieselbe Rechnung wie im Rest des Artikels: Zuerst kommt der Speicher, erst danach das Tempo.
Häufig gestellte Fragen
Reichen 24 GB im Mac mini M6 für Qwen 3.8-27B?
Nur sehr knapp, und ich würde es nicht empfehlen. Die rund 16 GB Gewichte von Qwen 3.8-27B passen auf dem Papier in 24 GB. Allerdings gibt macOS der GPU nicht den gesamten Unified Memory frei. Ein Teil bleibt für das System und deine offenen Programme reserviert. Dazu kommt der Kontext: Der KV-Cache, in dem das Modell den bisherigen Gesprächsverlauf vorhält, wächst mit jedem Token. Bei langen Dokumenten oder größeren Codebasen ist das schnell mehrere Gigabyte.
Im Alltag heißt das: Mit kurzem Kontext läuft das Modell vielleicht. Sobald du aber eine längere Datei einfügst oder nebenbei Browser und IDE offen hast, wird es eng oder das System lagert aus. Für den Apple Mac mini (M5 Pro, 24 GB, 512 GB) gilt dasselbe, denn der stärkere Chip ändert nichts an der Speichergrenze. Wenn 27B-Modelle dein Ziel sind, plane mindestens 32 GB ein. Der Apple Mac Studio (M5 Max, 36 GB) ist hier die entspanntere Wahl. Mit 24 GB fährst du besser mit kleineren Modellen wie Gemma 4 12B.
Lohnt es sich, auf Qwen 4 zu warten?
Für die Hardware-Entscheidung eher nicht. Qwen 4 wird jederzeit erwartet, war bei Redaktionsschluss aber noch nicht erschienen. Größe und Speicherbedarf kennt also noch niemand verlässlich. Selbst wenn ein neues Modell besser abschneidet, bleibt die Rechnung gleich: Ein Modell um die 30B passt in 4-Bit-Quantisierung in 32 bis 36 GB, größere MoE-Modelle brauchen deutlich mehr. Ein Rechner, der heute Qwen 3.8-27B sauber stemmt, wird mit hoher Wahrscheinlichkeit auch den Nachfolger in ähnlicher Größe laden.
Auf die Software musst du ohnehin nicht warten. Ein neues Modell lädst du einfach herunter, wenn es erscheint. Am Rückstand von rund einem halben Jahr zur Cloud-Spitze dürfte auch Qwen 4 wenig ändern.
Läuft Gemma 4 ohne dedizierte GPU?
Ja, zumindest die kleinen Varianten. Gemma 4 gibt es in fünf Größen. E2B und E4B sind ausdrücklich für sparsame Geräte gedacht, laufen mit bis zu 128K Kontext und verarbeiten sogar Audio. Laden kannst du sie zum Beispiel über Docker mit docker model pull gemma4. Die Lizenz ist Apache 2.0, du darfst die Modelle also auch kommerziell nutzen.
Damit reicht schon ein Mini-PC mit integrierter Grafik wie der Geekom A5 Pro für 549 € oder der Minisforum UM890 Pro (32 GB, 1 TB), um kleine Assistenzaufgaben, Zusammenfassungen oder einfache Chatbots lokal zu betreiben. Erwarte aber keine Wunder: Für anspruchsvolle Code-Assistenz auf dem Niveau von Qwen 3.8-27B sind E2B und E4B schlicht zu klein. Die mittleren Gemma-4-Größen (12B, 26B A4B, 31B) brauchen wieder deutlich mehr Speicher.
Was ist mit Nvidias RTX Spark (N1X)?
Das ist ein Arm-Chip mit Blackwell-Grafik und Unified Memory, also im Prinzip Nvidias Antwort auf Apples M-Chips und AMDs Strix-Halo-Linie. Spannend ist das vor allem, weil damit CUDA in einem Rechner mit gemeinsamem Speicher landet, ohne dass du eine separate Grafikkarte brauchst. Laptops mit RTX Spark sind bereits erhältlich, die kompakten Desktop-Rechner kommen erst noch.
Belastbare Zahlen zu Preis, Speicherausbau und LLM-Tempo der Desktop-Varianten habe ich noch nicht gefunden. Wer jetzt kauft, entscheidet also ohne sie. Das ist kein Drama: Brauchst du heute einen Rechner, nimm eine der Empfehlungen oben. Bist du ohnehin noch unentschlossen und an CUDA gebunden, kann es sich lohnen, die ersten Einschätzungen zu den Mini-Desktops abzuwarten, statt 9.995 € für eine RTX 5090 auszugeben.
Kurz gesagt
Für 27B-Modelle solltest du nicht bei 24 GB sparen. Auf Qwen 4 oder RTX Spark musst du nur warten, wenn du ohnehin keinen akuten Bedarf hast. Für die kleinen Gemma-4-Modelle reicht dagegen schon ein günstiger Mini-PC ohne eigene Grafikkarte.