Die besten KI-Workstations für große Sprachmodelle 2026
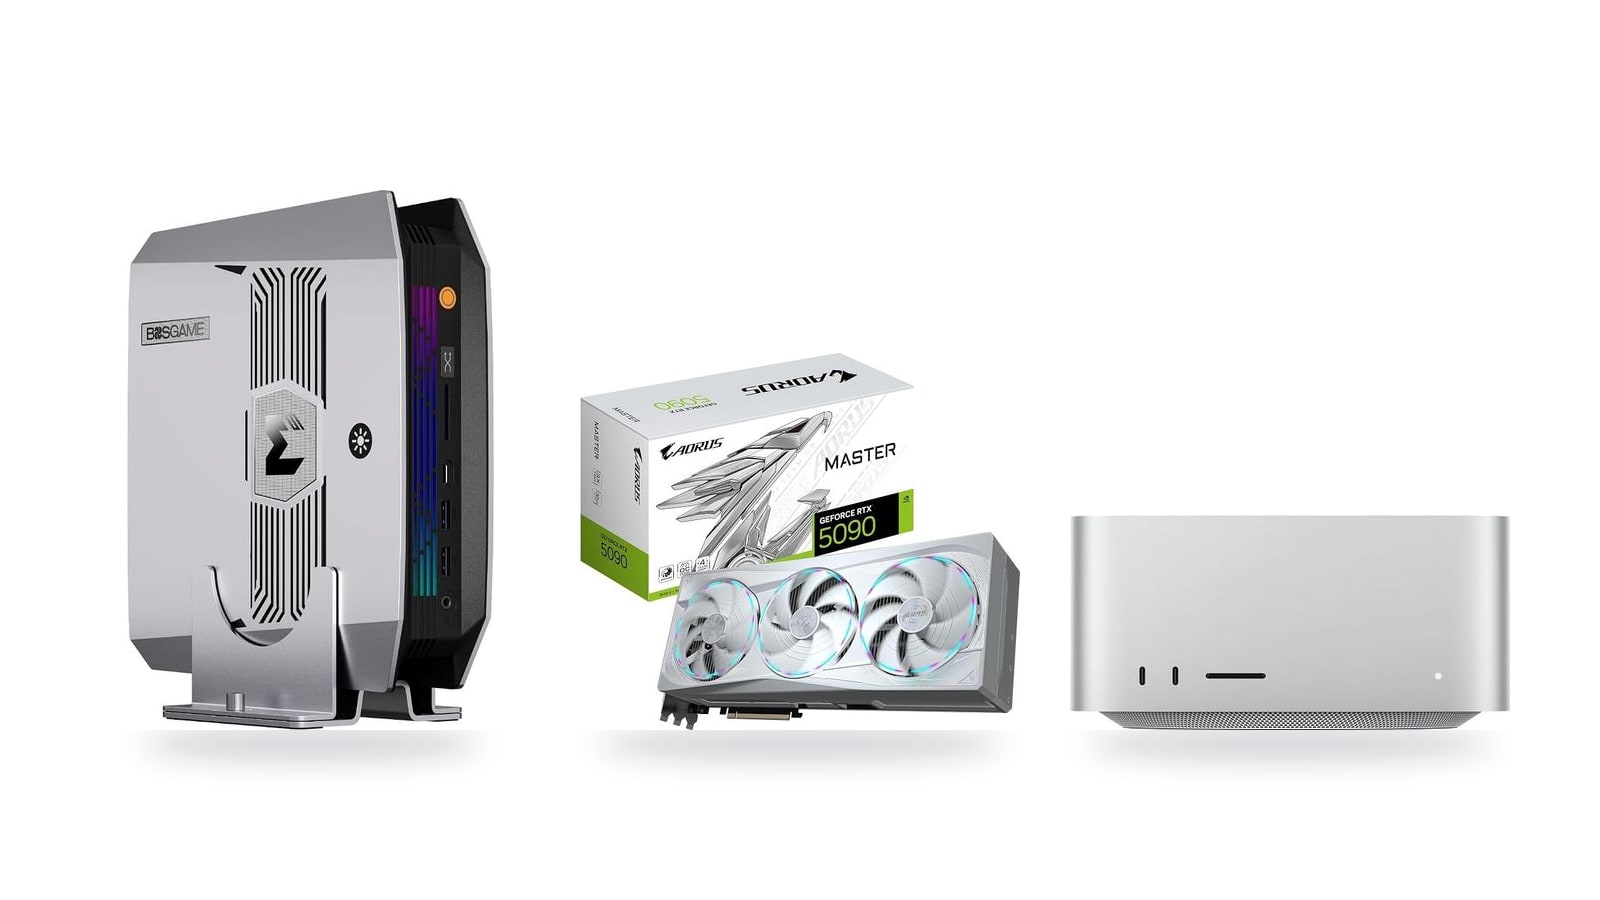
Qwen 3.8-27B schlägt in mehreren Benchmarks Claude Opus 4.6 und braucht als Q4-Quantisierung nur rund 16 GB. Entscheidend ist deshalb, wie viel Speicher dir für längeren Kontext und größere Modelle bleibt. Hier siehst du, welche der drei Optionen für deine Modelle reicht und wo du für Leistung zahlst, die du gar nicht nutzt.
Schnellauswahl: welche Workstation zu dir passt
Hinweis: Diese Seite enthält Affiliate-Links. Kaufst du darüber, erhalten wir eine Provision. Für dich ändert sich der Preis nicht.
Bei lokaler KI entscheidet zuerst der Arbeitsspeicher, welches Sprachmodell du überhaupt laden kannst. Erst danach zählen die Token pro Sekunde. Die drei Optionen unten setzen genau hier unterschiedlich an: viel Speicher, günstiger Einstieg oder hohe Geschwindigkeit.
Die drei KI-Workstations im Überblick
| Produkt | Bewertung | Preis | Kaufen |
|---|---|---|---|
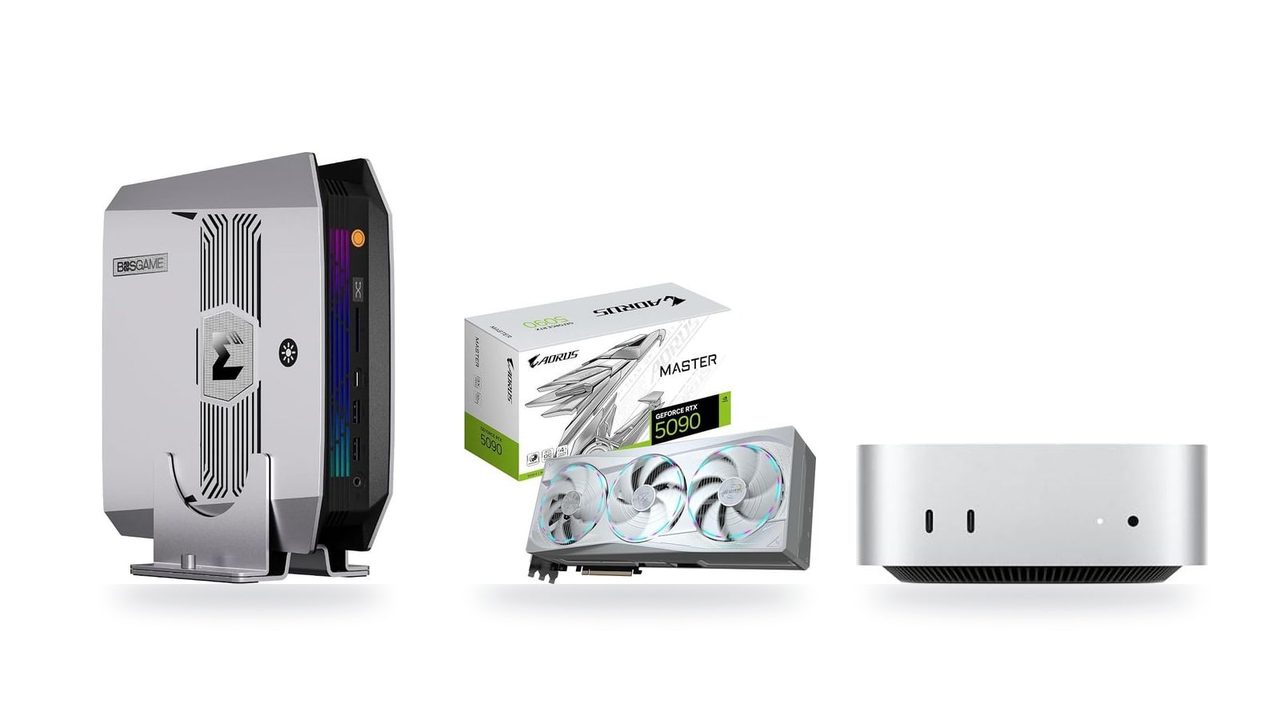
 Bosgame M5 (Ryzen AI Max+ 395, 128 GB, 2 TB) 128 GB Unified Memory im Mini-PC: Platz für große lokale LLMs +128 GB Unified Memory für große LLMs+Radeon 8060S: Bildgenerierung ohne Grafikkarte -RAM verlötet, später nicht aufrüstbar | 3.699,00 € | Kaufen → | |
 Nvidia GeForce RTX 5090 32 GB GDDR7 an 512 Bit: 27B-Modelle wie Qwen 3.8 laufen komplett im VRAM +32 GB VRAM: 27B-Modelle samt Kontext+512 Bit: zügigere Token-Ausgabe -Preis weit über der RX 9070 XT | 9.995,00 € | Kaufen → | |
 Apple Mac Studio (M5 Max, 36 GB) 36 GB Unified Memory für 27B-Modelle wie Qwen 3.8 – leise auf dem Schreibtisch +36 GB: Qwen 3.8-27B passt komplett+Neural Accelerator je GPU-Kern -36 GB verlötet, später nicht aufrüstbar | 2.599,00 € | Kaufen → |
Preise vom 16. Nov. 2026, sie können sich inzwischen geändert haben.
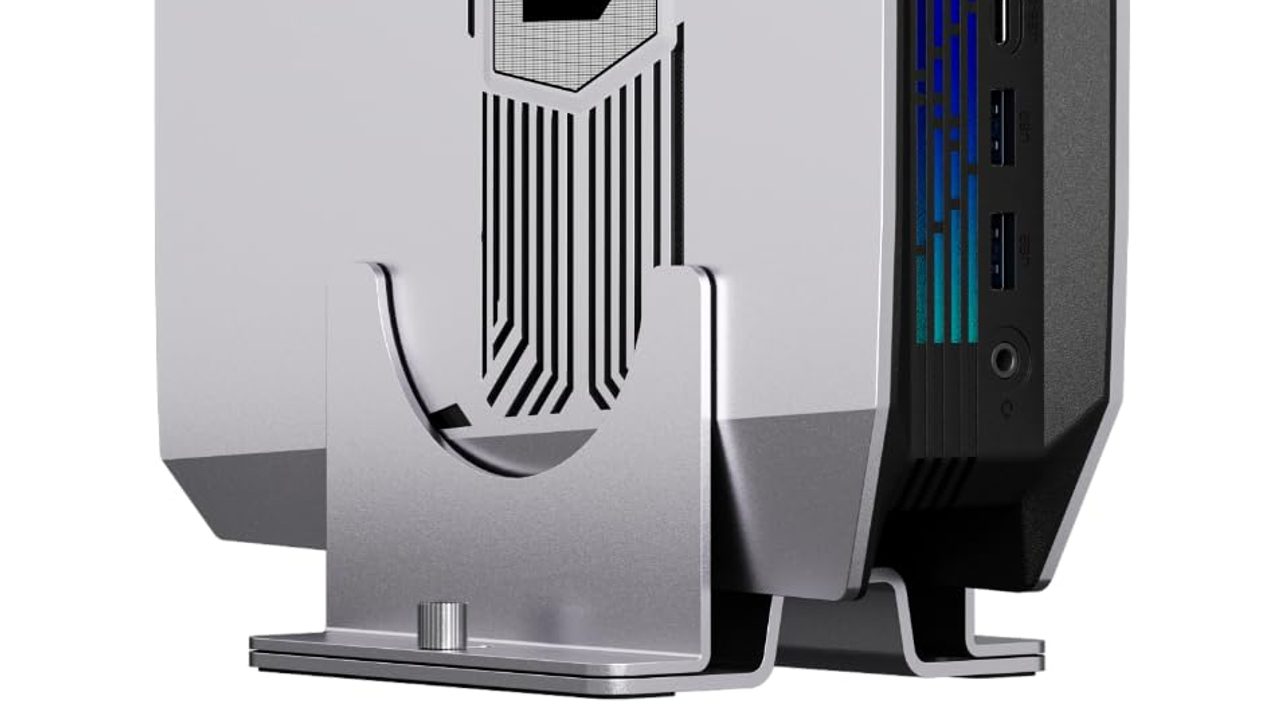
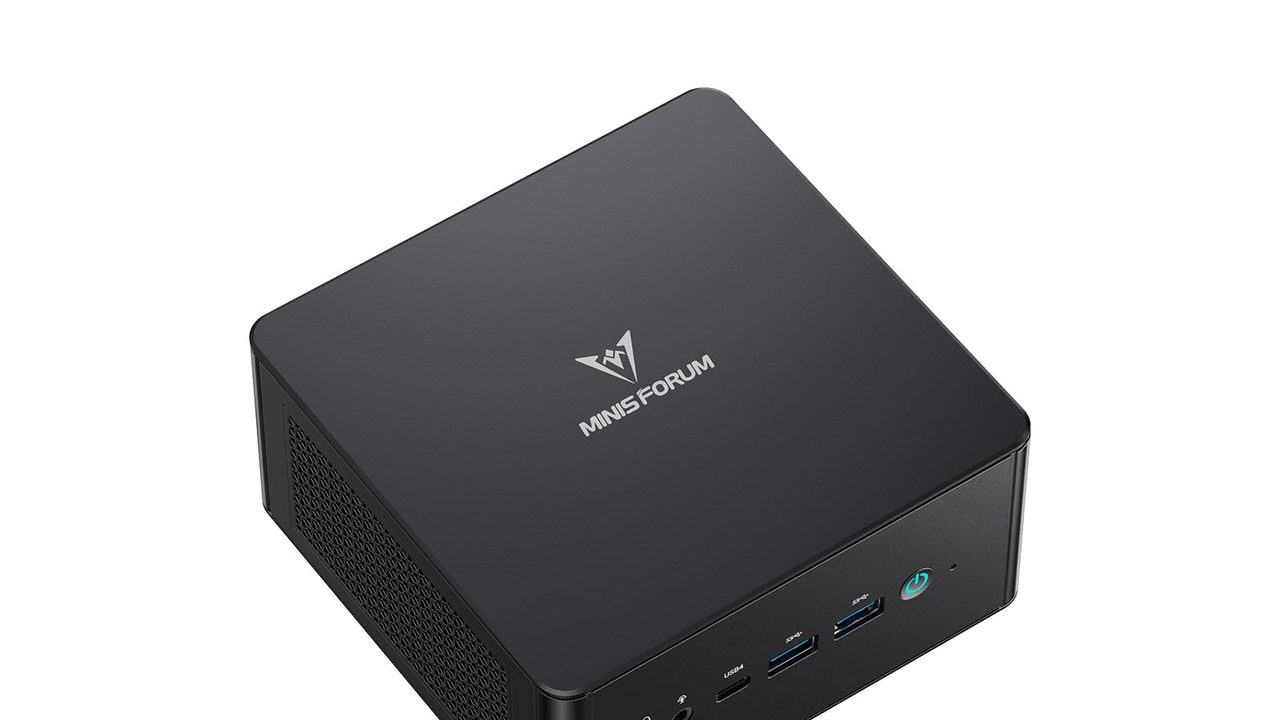
Mit 128 GB gemeinsamem Speicher und 2 TB SSD für 3.699 € lädst du Modelle und Kontextlängen, an denen die beiden anderen Optionen scheitern. Wer mehrere Modelle parallel vorhalten oder lange Dokumente verarbeiten will, bekommt hier die meiste Modellgröße pro Euro.
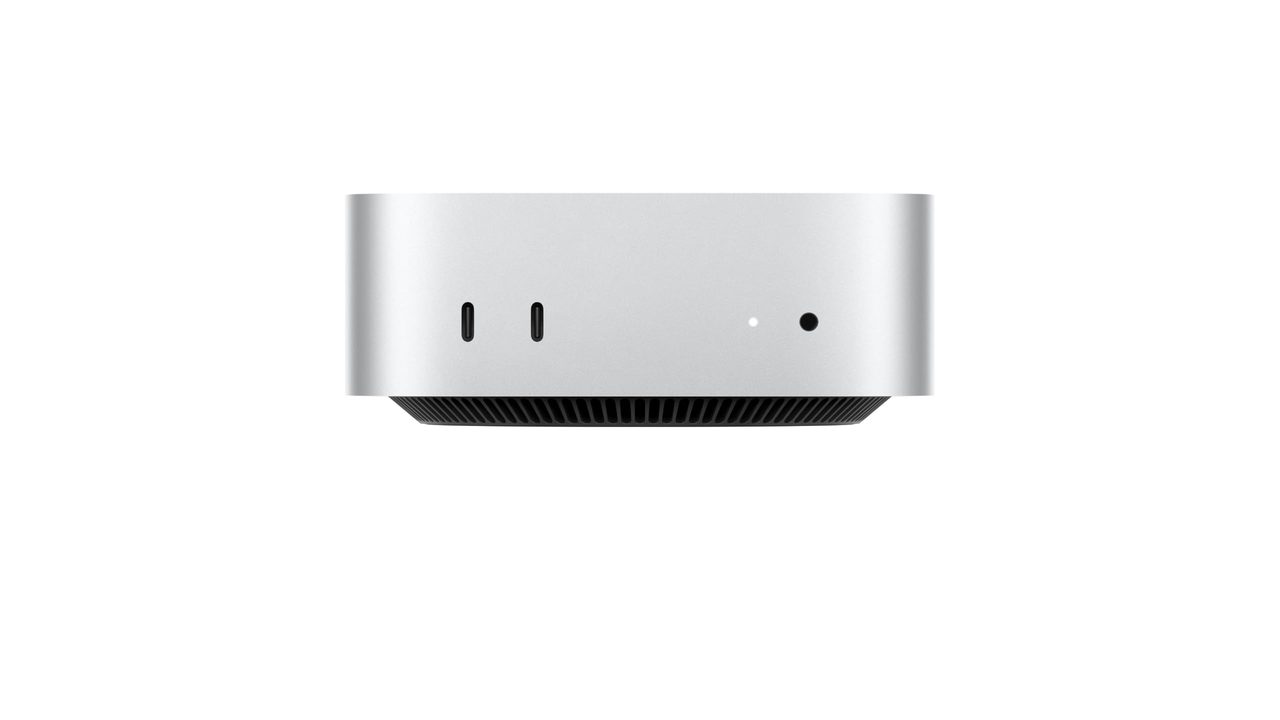
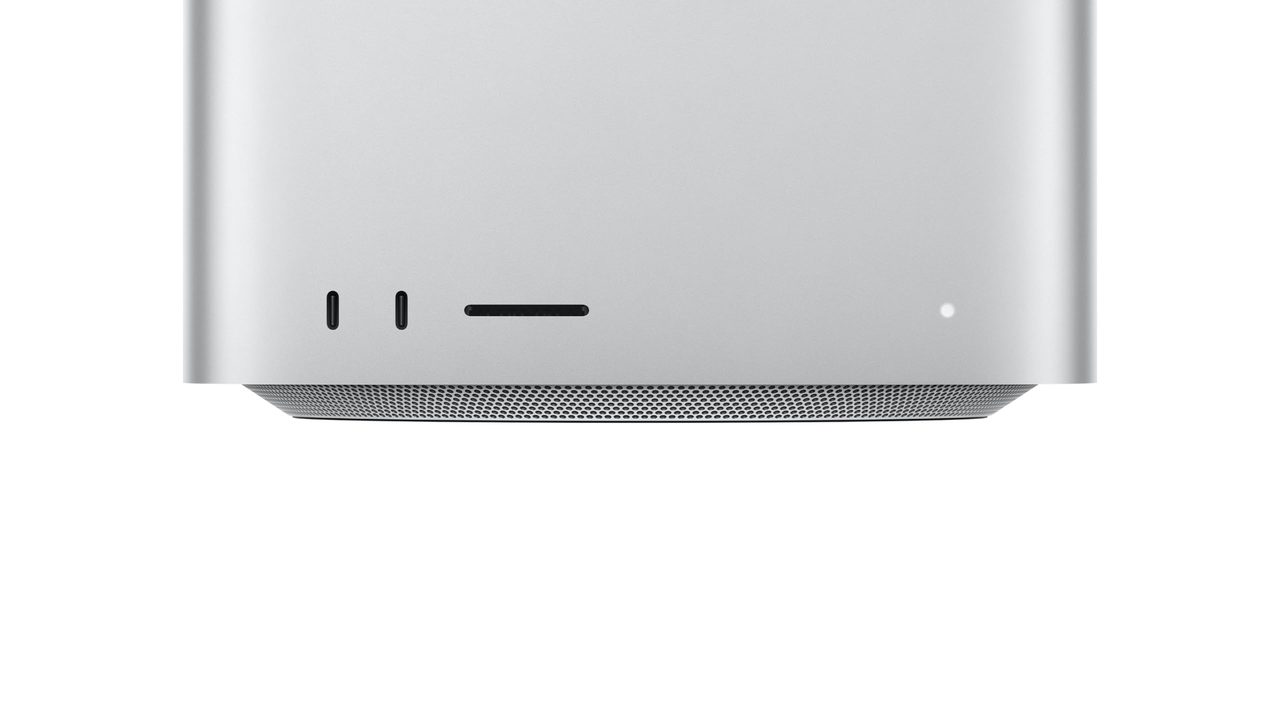
Für 2.599 € bekommst du einen leisen, fertigen Rechner aus Apples aktueller Generation (vorgestellt Ende August 2026), der Qwen 3.8-27B in Q4 ausführt. Mit 36 GB ist die Grenze aber früh erreicht, und die 512-GB-SSD ist schnell voll, sobald du mehrere Modelle ausprobierst.
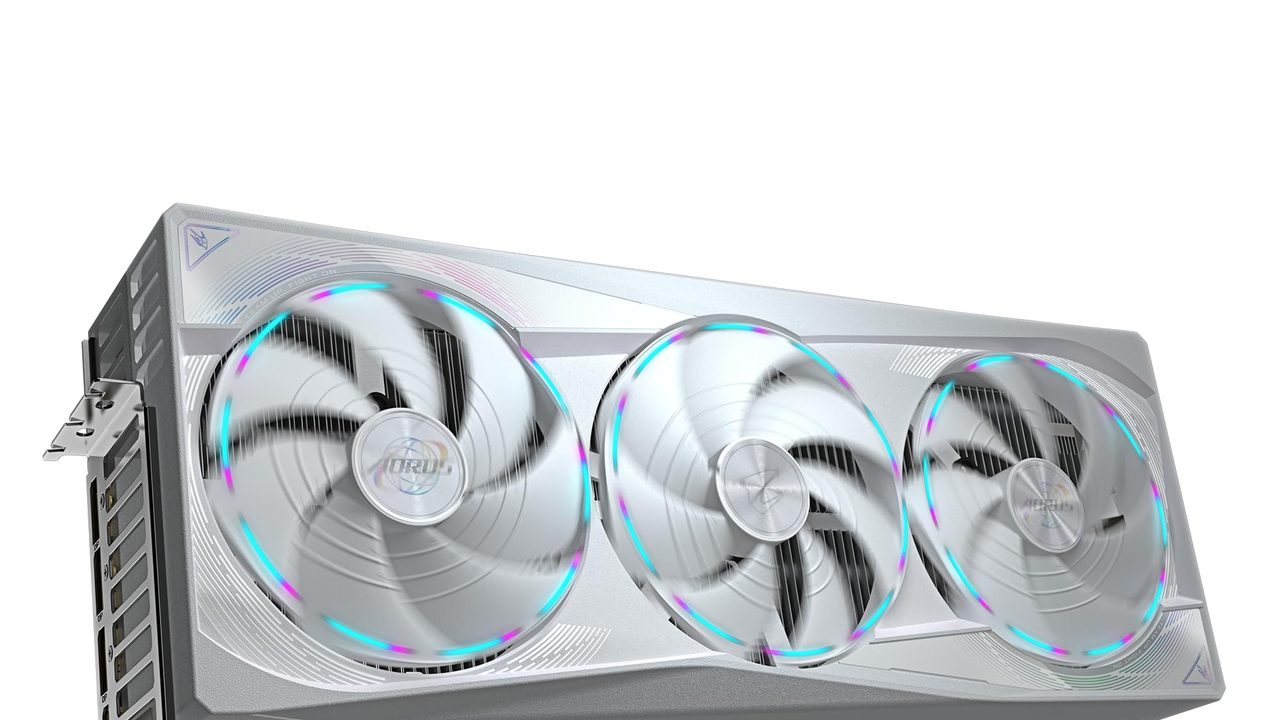
32 GB GDDR7 und CUDA liefern die höchste Geschwindigkeit für alle Modelle, die in den Grafikspeicher passen, und die breiteste Softwareunterstützung. Mit 9.995 € allein für die Grafikkarte ist sie aber die mit Abstand teuerste Option, und Gehäuse, CPU und RAM kommen noch dazu.
Entscheidungshilfe nach Priorität
| Deine Priorität | Passende Wahl | Der Haken |
|---|---|---|
| Möglichst große Modelle, langer Kontext | Bosgame M5 | Weniger Tok/s als eine dedizierte Grafikkarte |
| Niedrigster Preis, kompakt und leise | Apple Mac Studio (M5 Max, 36 GB) | 36 GB RAM und 512 GB SSD lassen sich nicht nachrüsten |
| Höchstes Tempo, CUDA-Software | Nvidia GeForce RTX 5090 | Fast 10.000 €, und nur 32 GB Grafikspeicher |
Unser Fazit für die Kurzentscheidung: Wenn du unsicher bist, wie groß deine Modelle in einem Jahr sein werden, ist der Bosgame M5 die sicherste Wahl. Der Mac Studio lohnt sich, wenn du heute mit Modellen um 27B arbeitest und dabei bleiben willst. Zur RTX 5090 greifst du nur, wenn Geschwindigkeit für dich wichtiger ist als die Modellgröße und das Budget keine Rolle spielt.
Alle drei Empfehlungen auf einen Blick

128 GB Unified Memory im Mini-PC: Platz für große lokale LLMs
- 128 GB Unified Memory für große LLMs
- Radeon 8060S: Bildgenerierung ohne Grafikkarte
- 2 TB SSD plus freier M.2-Slot
- RAM verlötet, später nicht aufrüstbar
- Unter KI-Dauerlast hörbar laut

32 GB GDDR7 an 512 Bit: 27B-Modelle wie Qwen 3.8 laufen komplett im VRAM
- 32 GB VRAM: 27B-Modelle samt Kontext
- 512 Bit: zügigere Token-Ausgabe
- Dual-BIOS: Lautlos-Modus für lange Läufe
- Preis weit über der RX 9070 XT
- 32-GB-Grenze: keine 70B-Modelle komplett

36 GB Unified Memory für 27B-Modelle wie Qwen 3.8 – leise auf dem Schreibtisch
- 36 GB: Qwen 3.8-27B passt komplett
- Neural Accelerator je GPU-Kern
- 4× Thunderbolt 5 für KI-Cluster
- 36 GB verlötet, später nicht aufrüstbar
- 512 GB SSD füllt sich mit Modellen
Preise vom 16. Nov. 2026, sie können sich inzwischen geändert haben.
Wie viel Arbeitsspeicher du für welches Modell brauchst
Bei lokaler KI gilt eine einfache Regel: Das Modell muss komplett in den Speicher passen, auf den die Recheneinheit direkt zugreift. Bei der RTX 5090 ist das der Grafikspeicher (VRAM). Beim Mac Studio und beim Bosgame M5 ist es das Unified Memory, das sich CPU und GPU teilen. Läuft der Speicher über, wird das Modell entweder gar nicht geladen oder die Token pro Sekunde brechen ein.
Zu den Gewichten kommt der KV-Cache dazu. Er speichert den bisherigen Gesprächsverlauf und wächst mit jedem Token Kontext. Lange Dokumente, große Codebasen oder Agenten-Workflows brauchen deshalb oft mehr Speicher als das Modell selbst.
Qwen 3.8-27B: der Maßstab für die Mittelklasse
Qwen 3.8-27B ist als Unsloth-GGUF in der Quantisierung UD-Q4KXL (etwa 4 Bit) rund 16 GB groß. Damit lässt es sich auf allen drei Optionen laden. Bei der RTX 5090 mit 32 GB bleibt etwa die Hälfte für den Kontext frei. Auf dem Mac Studio M5 Max mit 36 GB wird es enger, weil macOS und deine offenen Programme denselben Speicher nutzen. Für sehr lange Kontexte bleibt dort wenig Puffer.
Der native Kontext liegt bei 262.144 Token. Ein Nutzer hat ihn per YaRN auf 512K erweitert, allerdings auf einem MacBook Pro M5 mit 128 GB Unified Memory. In dieser Größenordnung kommt von den drei Optionen nur der Bosgame M5 mit.
Gemma 4 26B A4B: Warum MoE-Modelle anders rechnen
Gemma 4 26B A4B ist ein Mixture-of-Experts-Modell (MoE). Pro Token sind nur etwa 4 Mrd. Parameter aktiv, trotzdem müssen alle Gewichte im Speicher liegen. Das hat zwei Folgen: Beim Speicherbedarf zählt die volle Modellgröße. Bei der Geschwindigkeit verhält sich das Modell dagegen eher wie ein kleines. MoE-Modelle laufen deshalb auch auf Systemen mit geringerer Speicherbandbreite flott, etwa auf dem Bosgame M5, solange genug Arbeitsspeicher vorhanden ist.
Gemma 4 bietet bei den mittleren Größen 26B A4B und 31B 256K Kontext und steht unter der Apache-2.0-Lizenz. Du darfst es also auch kommerziell einsetzen.
| Szenario | Bosgame M5 (128 GB) | Mac Studio M5 Max (36 GB) | RTX 5090 (32 GB VRAM) |
|---|---|---|---|
| Qwen 3.8-27B UD-Q4KXL (~16 GB) | Passt mit sehr viel Reserve | Passt, wenig Puffer für Kontext | Passt, rund 16 GB frei für Kontext |
| Voller nativer Kontext (262K) | Realistisch | Nur stark eingeschränkt | Nur stark eingeschränkt |
| Per YaRN erweiterter Kontext (512K) | Machbar (Referenz lief mit 128 GB) | Nicht realistisch | Nicht realistisch |
| Gemma 4 26B A4B (MoE) | Ideal: viel Speicher, Bandbreite zweitrangig | Läuft, mit knappem Kontext | Läuft schnell, Kontext begrenzt |
| Mehrere Modelle gleichzeitig laden | Gut möglich | Kaum Spielraum | Kaum Spielraum |
Bei 4-Bit-Quantisierung brauchst du grob 0,6 GB pro Milliarde Parameter für die Gewichte. Das ergibt bei Qwen 3.8-27B die genannten 16 GB. Plane zusätzlich mindestens ein Drittel mehr für Kontext und System ein. Wenn du mit langen Dokumenten arbeitest, brauchst du deutlich mehr.
Wenn du vor allem mit 27B-Modellen bei normaler Kontextlänge arbeitest, reichen 32 bis 36 GB aus. Sobald du lange Kontexte, größere MoE-Modelle oder mehrere Modelle parallel nutzen willst, führt am Bosgame M5 mit 128 GB kaum ein Weg vorbei.
Ehrlich eingeordnet: Generationen, Preise und Ausblick
Bevor du kaufst, solltest du eines wissen: Der Ryzen AI Max+ 395 (Strix Halo) im Bosgame M5 ist nicht mehr die aktuelle Generation. AMD hat mit Gorgon Halo nachgelegt, also dem Ryzen AI Max+ PRO 495 mit Radeon-8065S-Grafik. Im GMKtec EVO-X5 Pro kommt er mit 192 GB Unified Memory und Platz für bis zu 24 TB Speicherplatz. TechRadar hat damit sogar ein Sprachmodell mit 300 Mrd. Parametern ausprobiert.
Der Haken ist der Preis. Der EVO-X5 Pro kostet ab 6.799 $ bzw. 5.299 £ und liegt damit weit über den 3.699 € für den Bosgame M5. Den hohen Aufpreis für 64 GB mehr Arbeitsspeicher holst du nur herein, wenn du Modelle laden willst, die in 128 GB schlicht nicht passen. Für Modelle wie Qwen 3.8-27B samt langem Kontext ist die Vorgängergeneration weiterhin das deutlich bessere Angebot.
| Plattform | Chip | Speicher | Stand November 2026 |
|---|---|---|---|
| Strix Halo | Ryzen AI Max+ 395 | bis 128 GB Unified Memory | Vorgängergeneration, z. B. im Bosgame M5 für 3.699 € |
| Gorgon Halo | Ryzen AI Max+ PRO 495 | bis 192 GB Unified Memory | aktuell, ab 6.799 $ |
| Nvidia RTX Spark | N1X (Arm + Blackwell) | Unified Memory | Laptops erhältlich, Mini-PCs kurz vor dem Start |
Was als Nächstes kommt
Nvidias RTX Spark (N1X) ist ein Arm-Chip mit Blackwell-Grafik und gemeinsamem Speicher. Er betreibt Windows-Rechner ganz ohne CPU von AMD oder Intel. Laptops gibt es bereits, kompakte Mini-PCs sollen in Kürze folgen. Spannend ist das vor allem wegen CUDA: Damit hättest du erstmals die breite Softwareunterstützung von Nvidia mit einem großen gemeinsamen Speicher in einem Gerät. Wer nicht drängt, kann die ersten Preise und Speicherausbauten abwarten.
Auch bei den Modellen bewegt sich viel. Qwen 4 wird jeden Moment erwartet. Lokale Modelle liegen etwa ein halbes Jahr hinter der Cloud-Spitze wie Claude Opus 5.5 zurück. Was heute nur in der Cloud läuft, landet also bald auf deinem Schreibtisch, und solche Modelle werden eher größer als kleiner. Mehr Arbeitsspeicher kaufst du deshalb vor allem für die Zukunft. Genau hier fallen die 36 GB des Mac Studio M5 Max zuerst zurück.
Warten auf günstigere Preise?
Darauf solltest du dich nicht verlassen. KI-taugliche Hardware ist massiv teurer geworden. Eine vier Jahre alte RTX 4090 kostet gebraucht rund 4.000 €, neu bis zu 5.000 €. Zum Marktstart lag ihr Preis noch bei 1.769 €. Dazu kommt die Knappheit bei Speicherchips: Selbst beim Mac mini, der inzwischen erst bei 1.049 € startet, waren viele Konfigurationen monatelang kaum lieferbar. Mit einer schnellen Entspannung ist nicht zu rechnen.
Brauchst du jetzt 128 GB für große Modelle oder langen Kontext, ist der Bosgame M5 trotz Vorgängerchip das vernünftigste Angebot pro Euro. Bist du nicht in Eile und setzt auf CUDA, warte auf die ersten RTX-Spark-Mini-PCs. Zur Gorgon-Halo-Klasse greifst du nur, wenn du ganz konkret mehr als 128 GB Arbeitsspeicher brauchst.
Häufige Fragen
Hier findest du kurze Antworten auf die Fragen, die vor dem Kauf am häufigsten auftauchen, von der Bildgenerierung bis zur Alternative im eigenen Gaming-PC.
Häufig gestellte Fragen
Kann ich mit den drei Rechnern auch Bilder generieren?
Ja. Aktuelle lokale Bildmodelle wie Flux.2, Krea-2, Qwen und Z-Image laufen in ComfyUI. Bei knappem Grafikspeicher setzt PCGH auf die Turbo-Varianten in FP8- oder BF16-Genauigkeit, als Unterbau bevorzugt mit Python 3.13. Die Nvidia GeForce RTX 5090 hat dank CUDA die breiteste Softwareunterstützung und macht hier am wenigsten Ärger. Auf dem Bosgame M5 und dem Apple Mac Studio (M5 Max, 36 GB) musst du eher mit Einschränkungen bei Plugins und Workflows rechnen.
Reicht nicht auch ein normaler Gaming-PC?
Für den Einstieg oft schon. Laut heise schafft eine Radeon RX 9070 XT für rund 920 € in einem gewöhnlichen Gaming-PC sinnvolle lokale KI-Arbeit, Coding eingeschlossen. Auch Qwen 3.8-27B läuft laut heise auf einem Gaming-PC. Die Grenze setzt der Grafikspeicher einer solchen Karte: Für langen Kontext oder größere Modelle bleibt wenig Luft. Wer regelmäßig größer arbeiten will, braucht 32 GB wie bei der RTX 5090 oder gleich 128 GB Unified Memory wie beim Bosgame M5.
Lohnt der Mac Studio mit 36 GB, wenn ich später größere Modelle nutzen will?
Eher nicht. Beim Mac Studio ist der Arbeitsspeicher fest verlötet und lässt sich nicht aufrüsten. Was du beim Kauf wählst, bleibt dein Limit für die gesamte Nutzungsdauer. Apple bietet den Mac Studio zwar mit bis zu 512 GB an, diese Ausstattungen kosten aber deutlich mehr als die hier empfohlene Version mit 36 GB. Wenn du heute schon weißt, dass du wachsen willst, liefert der Bosgame M5 für 3.699 € mit 128 GB mehr als das Dreifache an Speicher für etwa 1.100 € Aufpreis.
Wie starte ich am schnellsten?
Mit Docker reicht ein Befehl: docker model pull gemma4 lädt Googles Gemma 4 direkt von Docker Hub. Wer mehr Kontrolle möchte, nimmt llama.cpp mit einem GGUF-Modell, zum Beispiel Qwen 3.8-27B als Unsloth-Quant UD-Q4KXL. Beide Wege funktionieren auf allen drei Plattformen. Auf dem Mac lohnt sich zusätzlich ein Blick auf MLX.
Wie wichtig ist die SSD-Größe?
Wichtiger als viele denken. Schon ein einzelnes 27B-Modell in 4 Bit belegt einen zweistelligen Gigabyte-Betrag, und meist sammeln sich schnell mehrere Modelle und Quantisierungen an. Die 512 GB im Mac Studio sind dann schnell voll. Die 2 TB des Bosgame M5 bieten deutlich mehr Spielraum.
Neueste Bewertungen
Ratgeber & Artikel